线性表
栈
stack一种 FILO first in last out(先进后出)的数据结构,常用于递归问题求解
常用场景:数制转换、迷宫求解、树的个数、括号匹配、表达式求值等等
先采用数组模拟的方式看看栈容器的实现:
int st[N];
// 这里使用 st[0] (即 *st) 代表栈中元素数量,同时也是栈顶下标
// 压栈 :
st[++*st] = var1;
// 取栈顶 :
int u = st[*st];
// 弹栈 :注意越界问题, *st == 0 时不能继续弹出
if (*st) --*st;
// 清空栈
*st = 0;
如何理解栈?
举个例子,拿字符串的左右括号匹配问题说明(给定一串字符串,只包含[]、{}、()这三种类型的括号,是否合法匹配),这道问题可以依靠栈的思想来解决。
思路:右括号都需要寻找离他最近的、还没有匹配的左括号,这里栈这个数据容器只存放还没等到右括号的左括号,因为我们习惯于自左向右进行匹配,而偏偏最需要注意的右括号可能都在右侧存放,很多层次的左括号也不能这样扔掉,所以栈就需要这样的存储左括号(栈在这里就是一个等待匹配的清单),如最近一次放进去的左括号应该被第一次遇到的右括号进行匹配(这就是后进先出)
匹配的过程:只有当关闭括号即右括号出现时,才会进行匹配。有这样的几步
(1)先看栈是不是为空,若栈为空代表没有可以和当前右括号匹配的左括号,直接就是不合法匹配;栈不空进行下一步
(2)看栈顶是谁(合法匹配应该为:离当前括号最近的还没匹配的左括号)
(3)匹配的类型是否配对,配对继续进行后续的比较,否则代表不合法
(4)重复上述流程,在所有字符遍历过后,若栈不为空,说明没有匹配完(左括号多)代表失败,否则匹配成功
/**
	该函数实现的功能为:给定一个字符串,判断括号是否匹配
**/
bool isValid(string s) {
	stack<char> st;
    for(char c : s) {
        if(c == '(' || c == '[' || c == '{') st.push(c);
        else {
            if(st.empty()) return false;
            char x = st.top();
            if(x == '[' && c != ']') return false;
            if(x == '(' && c != ')') return false;
            if(x == '{' && c != '}') return false;
            st.pop();
        }
    }
    return (st.empty() ? true : false);
}
STL 栈的操作
stack<int> s;
// 新建两个栈 st1 和 st2
std::stack<int> st1, st2;
// 为 st1 装入 1
st1.push(1);
// 将 st1 赋值给 st2
st2 = st1;
// 输出 st2 的栈顶元素
cout << st2.top() << endl;
// 输出: 1
栈的使用都是一种基于角色的转变,比如一开始的括号匹配问题,栈充当 等待匹配 的角色,而进一步一个问题
相邻重复字符消除:删除字符串中所有相邻重复字符,反复删除直到不能删。如 abbaca → ca 这种栈的角色就是 最近有效状态 栈的存储就是已经“确认保留”的字符(把遍历到的每一个字符进行一个过滤筛选放入栈中)。
栈进阶:
(2)栈 = 嵌套结构的上下文
题目:字符串解码3[a2[c]] → accaccacc
思维:栈存的是进入内层前的外层状态,在遇到 ] 时恢复
队列
queue一种 FIFO (first in first out)先进先出的数据结构
queue<int> q;    // 普通队列
deque<int> q;    // 双端队列(存在前后双指针)
priority_queue<int,vector<int>,greater> q;      // 优先队列
链表
按值传递:int、long、byte、short、char、float、double、bool、string
按引用传递:自定义类、数组
按引用传递传递的参数是新拷贝一份地址和原地址指向同一个位置
单链表定义:节点在内存中存有数据和下一个节点的指针
双向链表:在单链表基础上,增加一个prior指针指向上一个节点的指针
在地址划分上,链表分为数据域、指针域
头节点 指针 指向第一个节点的地址
链表的基本操作:
// 头文件
#include <list>  // 双向链表
#include <forward_list>   // 单向链表
//单向链表
#include <forward_list>
std::forward_list<int> fl = {1,2,3};
fl.push_front(0);      // O(1)
fl.insert_after(fl.begin(), 42);
fl.remove(2);          // O(n)

//双向链表
#include <list>
std::list<int> lst = {1,2,3};
lst.push_back(4);
lst.insert(std::next(lst.begin()), 42);
lst.erase(lst.begin());
纯 C 实现的链表
// 数据结构定义 ( 非嵌入式 )
struct node {
    Type data;
    struct node* next;
};
// 嵌入式
struct node {
	Type data;
	struct link_node;  // 链表管理器
}
struct link_node {
    struct link_node* pre;
    struct link_node* next;
};
// 操作定义(侵入式为例)
// 尾插
#define Add_tail(head,node) 	\
	(node)->next = (head);		\
	(node)->pre = (head)->pre;	\
	(head)->pre->next = head;	\
	(head)->pre = node;
// 头插
#define Add_head(head,node)		\
1、反转链表
1—–> 2 ——> 3 ====> 3—-> 2—–> 1
头节点 变成3 ,1的next指向null

ListNode reverseList(ListNode head){
    ListNode pre = null;
    ListNode next = null;
    while(head != null){
        //next指针往前走
        next = head.next;
        //head下一个指针域指空
        head.next = pre;
        //pre指向head
        pre = head;
        //head指向下一个
    	head = next;
    }
}
串
模式串匹配
BF
string s,t;
for(int i = 0, j = 0; i < s.size() && j < t.size();){
	if(s[i] == t[j]) {
        ++i,++j;
    } else {
        i = i - j + 2;
        j = 0;
    }
    if(i == s.size() - 1 && j == t.size() - 1){
		// 匹配开始位置
        i - t.size();
    }
}
KMP
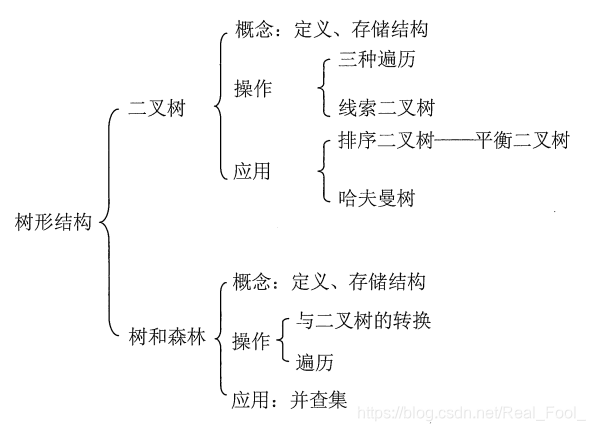
树型结构
基本概念
树是由一个或一个以上的节点组成的。树中存在一个特殊节点(树根 // 根节点),每个节点都是由一些数据和指针组合成的记录。每个节点本身也是一种树结构(即此根节点子树),一棵合法的树,节点间可以互相连接,但不能形成无出路的回路。
基本术语:
1、度数(degree):每个节点所有子树的个数,如A的度数为3,树的度【树中节点最大的度数】
2、层数(level):设A层数为1,则B、C、D层数为2
3、高度(height):树的最大层数,如图高度为4
4、树叶【或 终端节点】:度数为0的节点就是树叶,如图中K、L、F
5、非终端节点:树叶以外的节点,A、B、C、D、E、H
6、有序树【无序树】:树中节点的各子树从左到右为有序树,否则为无序树
7、森林:n课互不相交树的集合。将一棵树根节点删去就是森林,反之,给n课独立的树加上一个节点,并把这n课树作为该节点的子树,森林就变回了树。
性质:
1.树的节点数 = $ m+1$,其中 $m$ 为树的边数
2.度为 $m$ 的树中第 $i$ 层 最多有 $m^i$-1 个节点
3.高度为 $h$ 的 $m$ 叉树 最多有 ($m^h$ -1)/(m-1)个节点
4.具有 $n$ 个节点的 $m$ 叉树 $min(h)=log_m(n*(m-1)+1)$
二叉树遍历
二叉树的遍历是指 从根结点出发,按照某种次序一次访问二叉树中的所有结点,使得每个结点被访问一次且仅被访问一次
1、前序:根左右
先访问根节点,再递归访问左节点,最后递归访问右节点
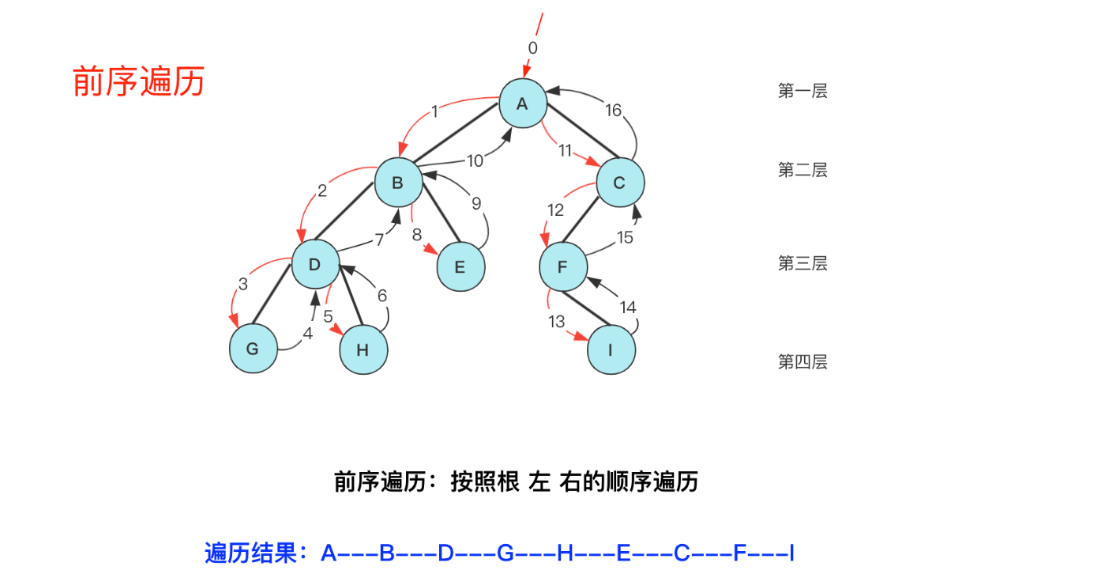
void dfs(int x)
{
    if (a[x] == -1) {
        return;
    }
    cout << a[x] << " ";
    dfs(2 * x + 1);
    dfs(2 * x + 2);
}
2、中序:左根右
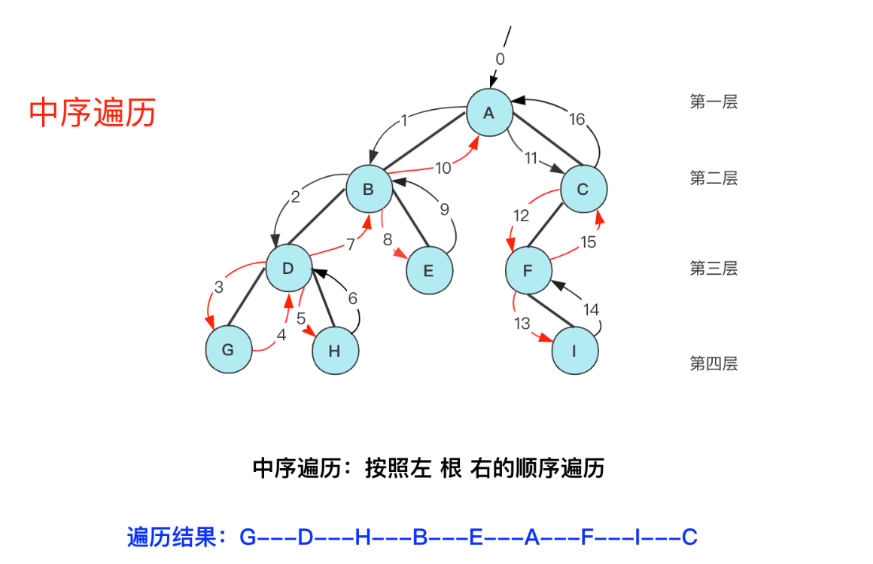
void dfs(int x)
{
    if (a[x] == -1) {
        return;
    }
    dfs(2 * x + 1);
    printf("%d ", a[x]);
    dfs(2 * x + 2);
}
3、后序:左右根
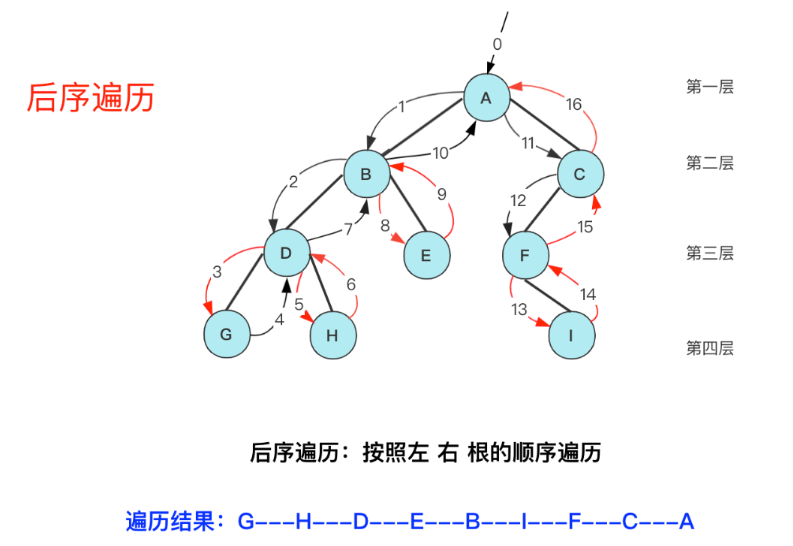
void dfs(int x)
{
    if (a[x] == -1) {
        return;
    }
    dfs(2 * x + 1);
    dfs(2 * x + 2);
    printf("%d ", a[x]);
}
序列建树
对于给定的遍历序列如:前序 + 中序、后序 + 中序 两种遍历方法可以推出唯一的树,构建方法
特殊二叉树
满二叉树:深度为 $k$,且节点数为 $2^k-1$ 的二叉树
完全二叉树:深度为 $k$,有 $n$ 个节点的二叉树,且自上而下,自左至右的每一个节点都与深度为k的满二叉树中编号对应
完全二叉树性质:
1、叶子结点只用出现在最下两层
2、最下层的叶子一定集中在左部连续位置
3、倒数两层若有叶子结点,一定都在右部连续位置
4、如果结点度为1,则该结点只有左孩子
5、同样结点数的二叉树,完全二叉树的深度最小
节点 $i$ 父亲节点公式:$(i - 1)/ 2$ ,0 的父亲节点是自己
左儿子:$2\times i+1$ 右儿子:$2 \times i+2$
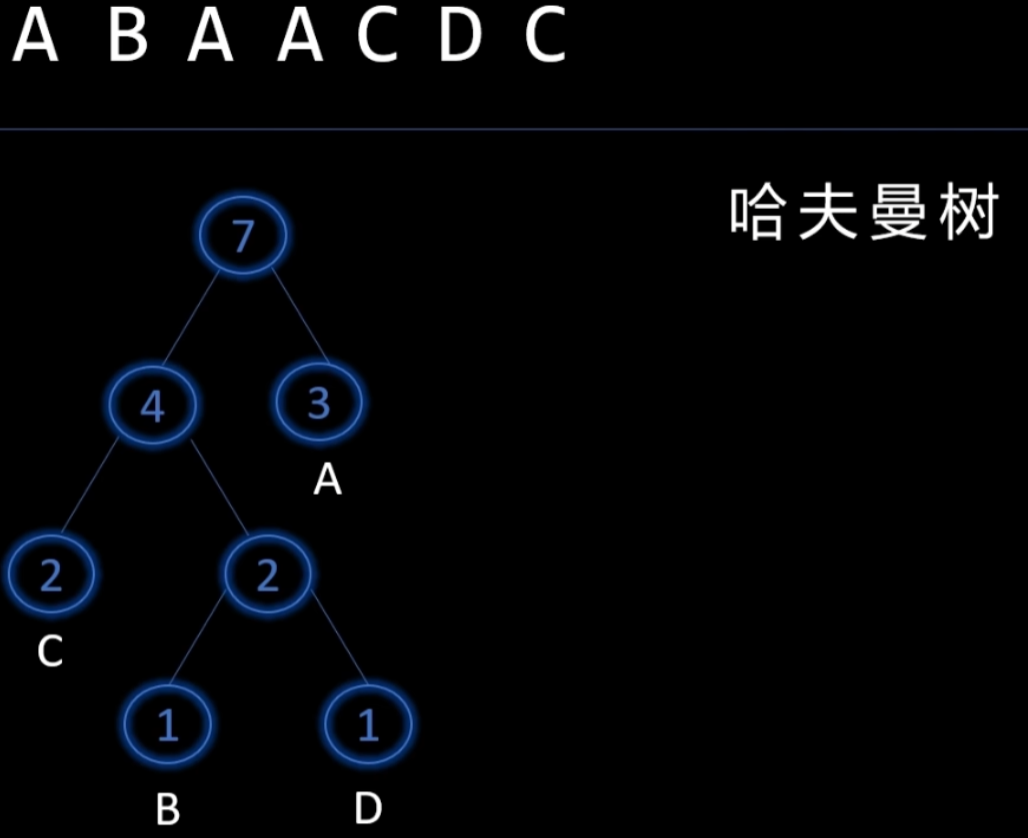
哈夫曼树及编码
编码原则:不出现重复前缀,如(01、011 就是重复的前缀)
哈夫曼编码:在不出现歧义的情况下编出的码长度一定是最短的
构建哈夫曼树:
1、统计各个字符出现的次数
2、将字符的出现次数最少的开始,合并成一个父节点,继续和出现次数第二小的字符合并节点操作……
3、将边标号(左 0 右 1)
4、从根节点开始到需要编号的节点经过的路径,如A:01,B:010 ,C:00,D:011
该字符串的编码:1010110001100(13)可能 一定是最短的编码长度
- 出现次数越多的字符编码越短
- 哈夫曼树不存在奇数度节点
堆(完全二叉树)
大根堆:这个结构中的任何一个子结构最大值都必须在顶部,即最大值为根节点
从整棵树的最后一颗子树开始调整,每次都让根节点和左右孩子去比较,如果根节点比左右孩子的最大值要小,那么就将这两个值进行交换,然后此时这颗子树变成了大根堆
小根堆:在这个结构中,改变当前位置的值
父亲节点:(i - 1) / 2
左孩子 : i * 2 - 1 右孩子 : i * 2 + 1
//down
void InitialHeap(int parent,int end){
    //大根堆
	int child = parent * 2 + 1;
	while(child < end){
		if(child+1 < end && a[child+1] > a[child]) child++;
		if(a[child] > a[parent]){
			swap(a[child],a[parent]);
			parent = child;
			child = 2 * parent + 1;
		}else{
			break;
		}
	}
}
for(int parent=n-1;parent >= 0; parent--){
		InitialHeap(parent,n);
	}
//堆的up
void upHeap(int index){
    while(heap[index] > heap[(index-1) / 2]) {
        swap(heap[index],heap[(index-1) / 2]);
        index = (index - 1) / 2;
    }
}
堆的应用:对顶堆(解决第k小/大的问题)、优先队列(频繁插入且有序的序列)
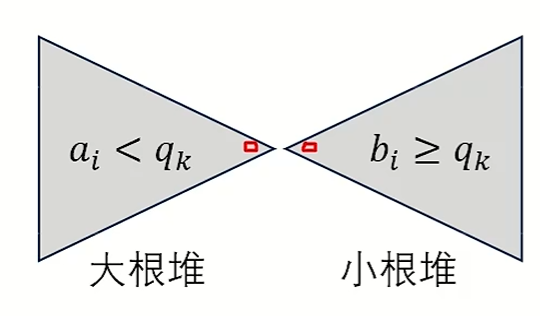
对顶堆:可以动态维护一个序列上第k大的数,k值会发生变化。
对顶堆由一个大根堆和一个小根堆组成,小根堆维护前k大的数(包含第k大),大根堆维护小于第k大的数
操作:
1、插入:插入的元素 >= 小根堆堆顶的元素,将该元素插入小根堆,否则插入大根堆
2、维护:小根堆大小 > k 时,将小根堆堆顶元素取出插入大根堆,直到小根堆元素个数 = k
小根堆大小 < k 时,从大根堆里取出元素插入小根堆,直到小根堆元素个数 = k
3、查询:查询第k大的元素,小根堆堆顶元素
4、删除:删除第k大元素,删除小根堆堆顶元素
priority_queue<int> a1; // 大根堆
priority_queue<int, vector<int>, greater<int>> a2; // 小根堆
int main(){
    int n, k;
    cin >> n >> k;
    for (int i = 1; i <= n; ++i) {
        int x;
        cin >> x;
        if (a2.empty() || x > a2.top()) {
            a2.push(x);
        } else {
            a1.push(x);
        }
        while (a2.size() > k) {
            a1.push(a2.top());
            a2.pop();
        }
        while (a2.size() < k && !a1.empty()) {
            a2.push(a1.top());
            a1.pop();
        }
    }
    printf("%d ", a2.top());
    a2.pop();
    return 0;
}
二叉排序树BST
二叉查找树,又称二叉搜索树。特点为:当前结点值 > 左孩子值,当前结点值 < 右孩子值
还有一个特性就是 中序遍历 可以得出有序序列
用处:快速搜索的任务,动态查找
         (4)
         /  \
       (2)   (6)
      /   \  /  \
    (1)  (3)(5) (8)
                  \
                  (9)
BST的平均查找长度和 log(n)等量级,但有时需在构建过程中完成 平衡化 处理,成为AVL(实现了AVL的 BST称为 BBST)
查找:时间复杂度: $O(\log_2 n)$
- 插入数据时保持大小关系,小于自己的放左边,否则放右边
- 按照中序进行遍历,得到排序结果(DFS 实现)
BST的删除,时间复杂度: $O(\log_2 n)$
- 删除的是叶子结点,直接删除即可
- 若删除的结点只有左子树 / 右子树,直接让存在的左右子树代替
- 若删除存在左右子树,找直接前驱 或者 后继 替换当前要删除的值,然后删除前驱或后继(原问题 ===> 删除左子树 / 右子树 / 叶子结点)
平衡二叉树 AVL/BBT
左子树和右子树深度之差绝对值不超过1,即 $| d_{l}-d_{r}| \le1$,其中 d 代表树高或者深度,且它的左右子树也为AVL
平衡因子(BF):| 该结点左子树 - 右子树的深度 | ,取值为$[-1,0,1]$
在构建 AVL 树的过程中,会出现 BF 值不合法情况,需要进行调整,比如
 (4)     /* BF = -2,不合法值 */                 (6)
   \                       进行调整             /  \
     (6)                     ==>              (4)  (8)
     /  \                                       \
    (5) (8)                                      (5)
AVL 树存在 4种调整,分别是单向左旋、右旋,双向旋转(先左后右、先右后左)
判断针对哪一个结点进行旋转操作:找到最小不平衡子树(即以当前结点为根节点时,$|BF| \ge 2$)
(1)单向左旋(RR)
   (4)                                        (6)
  /   \                                       /  \
(3)    (6)                  ==>              (4)   (8)
       /  \                                 / \
      (5) (8)                             (3)  (5)
          / \  // 若在此处插入结点,|BF| >= 2,则需要进行调整,正常4节点要变为6的左孩子,但和原本5冲突,因此冲突的左孩子变为右孩子,如右图
(2)单向右旋(LL)
     (6)                                    (3)
    /   \                                  /    \
  (3)    (8)             ==>             (4)     (6)
  / \		                                     / \
(4)  (5)						        	 (5) (8)
/ \
// 若在此处插入结点,|BF| >= 2 ,则需要进行调整,正常6节点需要右旋变为3的右孩子,但原本的3存在右孩子,因此冲突的右孩子要变为左孩子,如右图
(3)双向旋转(对失衡节点左孩子先左旋RR,后对失衡结点右旋LL,LR)
     	  (8)                                     (8)                            (5)
         /   \                                   /   \                          /   \
        (3)   (9)                               (5)   (9)                     (3)    (8)
       /  \               ===>                 /  \          ===>            /  \    /  \
     (2)  (5)                                (3)  (6)                      (2)  (4) (6)  (9)
          / \                                / \                                / \
        (4) (6)                            (2) (4)
        / \    /* 在此处插入结点 */             / \
(4)双向旋转(对失衡节点右孩子先右旋LL,后对失衡节点左旋RR,RL)
    (3)                                         (3)                                    (5)
   /    \                                      /  \                                   /   \
(1)     (7)                 ==>              (1)   (5)          ==>                 (3)    (7)
        /  \                                       /  \                            /  \    /  \
      (5)  (8)                                   (4)  (7)                        (1)  (4) (6)  (8)
      /  \                                       / \  /  \                            / \
    (4)  (6)                                         (6) (8)
    / \
   // 若在此处插入结点
接下来还有关于插入结点后进行什么样的平衡化的讨论,即当 BF 值分别在 -1,0,1 时该如何操作
在插入节点后,可能导致多个祖先结点失衡,只需要调整距离插入结点最近的失衡结点,其他结点自然平衡
     (3)  /* BF=-2 */                           (3)
	/  \     							    /   \
   (1)  (6)  /* BF=-2 (调整该结点)*/          (1)  (7)
          \              ==>                      /  \
           (7)                                   (6)  (9)
             \
              (9)
删除结点导致失衡,可能导致多结点失衡,需要沿着当前最近失衡结点调整,直到根节点
// 构建一棵 AVL [ 14 9 5 17 11 12 7 19 16 27]
       (11)
	 /    \
    (7)    (17)
   /  \    /   \
  (5) (9) (14) (19)
          /  \     \
         (12) (16)  (27)
针对这个例子,删除结点5
       (11)                                   (11)  /* (11)BF=-2 失衡RR型 */       (17)
	 /    \                                 /     \                              /     \
    (7)    (17) /* (7)BF=-2 失衡RL型 */   (8)      (17)                         (11)     (19)
      \    /   \            ==>          /  \      /   \                       /   \     /   \
      (9) (14) (19)                     (7) (9)  (14)  (19)    ==>            (8)  (14) (16)  (27)
      /    /    /  \                              /    /  \                  /  \  /            \
    (8)  (12) (16)  (27)                        (12) (16)  (27)            (7) (9)(12)         (23)
                    /                                      /
                   (23)                                   (23)
红黑树-RB树
背景:由于AVL树在插入时对于"平衡" 概念的严格要求,导致插入时可能效率较低,在实际工程中需要查找效率更高的解决办法,红黑树是一种基于BST和AVL树开发的,结点带有颜色(红、黑)的自平衡二叉排序树。通常 C++ 中的map、multiset,JAVA中的HashMap等数据结构底层为红黑树实现
性质:
- 每个结点的颜色为红或黑的一种
- 根节点,叶子结点(虚构的外部结点,NULL结点)一定是黑色
- 任意两个红色结点不能相邻,即红色结点的孩子或父亲一定是黑色结点
- 从根节点到 叶子节点的每条路径上的黑色节点数量相同
红黑树的查找:和BST一致,时间复杂度 $O(\log_2n)$
插入:相较于BST,红黑树需要考虑旋转和颜色问题,一般插入结点时,默认为红色。
- 若插入时为空树,插入结点为根节点,将结点染成黑色
- 若插入为非空树,父亲结点若为黑色,不需要任何操作;若父亲结点为红色,需要考虑插入结点的叔结点
(1)叔结点为红色:叔、爷、父结点变色,爷结点变为cur(变色后有相邻红色结点,以爷结点为基础,递归向上验证)
       (7)B								(7)R  /* cur,当前为根节点再次变色为 B*/
      /   \                               /   \
    (5)R   (8)R          ===>           (5)B   (8)B
    /                                   /
  (1)R /* 插入结点 cur */              (7)R
(2)叔结点为黑色:先通过AVL的四种旋转 LL、LR、RR、RL 以爷结点为准旋转,再将旋转点、旋转中心变色
注:RL、LR 需先进行一次旋转后,以最后一次的旋转点和旋转中心点为准变色
// RR型举例
       (7)B                                (9)B
          \                               /   \
           (9)R             ===>        (7)R   (12)R
             \
              (12)R  /*插入结点cur */
// LR型举例
       (7)B                                (5)                        (5)B
      /    \             /* 旋转后*/      /   \      /*染色后 */     /    \
     (3)R   [NULL]B        ====>        (3)   (7)    ===>          (3)R    (7)R
       \
        (5)R  /* 插入结点cur */
注:图中省略第一次旋转结果,第一次旋转后,是以5为旋转中心,7为旋转点,后续变色以此为基准
红黑树的删除:
- 只有左子树 或 只有右子树,直接使用删除结点的左/右子树代替,代替后颜色变黑(防止违反黑路结点相同性质)
- 左右子树都存在,找直接前驱或直接后继,用他们代替删除结点,问题转换为删除前驱或后继
- 没有孩子,对于红结点:不会破坏黑路同结点数目一致性质,可直接删除;对于黑色结点:删除必然违反性质,引入双黑结点的概念(代表该路径缺少一个黑色结点),后面需要对该双黑结点转变为单黑结点
// 删黑色结点,兄弟为黑(兄弟孩子至少一红),LL型
	    (7)B                  (7)B                        (5)B
	   /    \                 /   \                       /    \
      (5)B   [双黑]   ==>   (5)B   [双黑]    ==>        (2)B    (7)B
     /   \                 /   \                              /   \
    (2)R   (6)R          (2)B   (6)R                         (6)R  [空结点]
// 删黑结点,兄弟为黑(兄弟孩子至少一红) LR型
       (7)B 								    (7)B                          (6)R
      /   \       /*兄孩染色父亲,父亲变黑*/       /   \      /* LR旋转*/        /    \
    (5)B   [双黑]     ==>                       (5)B   [双黑]   ==>            (5)B   (7)B
       \                                         \                                      \
       (6)R    							       (6)R                                  [NULL]单黑
// 删黑结点,兄弟为黑,兄弟孩子均为黑(兄弟变红,双黑上移)
           (15)B                          (15)B                             (18)B
          /     \        /*双黑上移*/    /     \       /*RR型+染色*/        /     \
       (8)B       (18)B        ===>   (8)[双黑] (18)B     ==>            (15)B     (27)B
      /   \      /   \               /          /   \                   /   \      /    \
    (6)B [双黑] (17)B (27)R        (6)R       (17)B  (27)R            (8)B  (17)B (25)B  (34)B
                      /  \                           /  \            /
                    (25)B  (34)B                  (25)B  (34)B      (6)R
// 删除黑结点,兄弟为红:兄父变色,父亲朝双黑旋转,保持双黑继续调整
         (18)B                  (18)R                     (15)B                  (15)B
        /     \                /     \                   /     \                /    \
      (15)R   [双黑]   ==>   (15)B   [双黑]   ===>     (9)B    (18)R   ===>   (9)B    (18)R
     /    \                 /    \                            /    \                  /
   (9)B   (17)B           (9)B   (17)B                      (17)B  [双黑]           (17)R
注:若双黑结点遇到红色结点 或 根节点,可直接变为单黑
B-Tree
B-树 是一种平衡的多路查找树,在文件系统中很常用。对于m阶B-Tree,其有以下这些性质
- 有序:结点内有序(任一结点元素,左元素 < 本身 < 右元素)
- 平衡:所有的叶子结点都在同一层
- 多路:最多 m 个分支,m - 1 个元素
$最少 \begin{cases} 根节点:2分支,1元素 \\ 其他结点:\lceil{\frac{m}{2}} \rceil 分支,\lceil{\frac{m}{2}} \rceil-1 \end{cases}$
B 树,将每个叶子结点下连接一些空结点(外部结点),而含有数据的结点称为内部结点
查找:和二叉搜索树类似,首先从根节点开始,依次比较左右子树元素,首先会先将该结点的元素加载到内存中,在该结点内部,可采用线性查找、二分查找的方式(大于当前元素,右移,直到找到不大于的元素查找它的左子树)
插入:先找到插入元素位置,若插入了没有发生上溢出(结点内元素 > m-1),无需调整;否则以中间元素 $\lceil{\frac{m}{2}} \rceil$ 为分裂点,将分裂点元素上移,两边元素分裂开成为两个独立结点。插入时可能导致一系列的上溢出(直到根节点)
删除:删除结点类似于BST,中序查找到直接前驱 / 后继,替换完后,问题转换为删除叶子结点。若叶子结点删除没有发生下溢出(结点内元素 < $\lceil{\frac{m}{2}} \rceil-1 $)直接删除,否则查看左右的兄弟是否可以借结点元素(父下,兄弟上),若两边兄弟都不够借,那么将它和左右兄弟之一合并。删除时可能出现一系列下溢出(直到根节点)重复判断即可,注意上层的下溢出调整后,它的左 / 右 子树 需要移动
$ 叶结点元素\begin{cases} 没有下溢出:无需调整 \\ 下溢出\begin{cases} 兄弟够借 \\ 兄弟不够借:合并(父亲下移到左,然后右合并过来) \end{cases} \end{cases}$
演示文档: B-Tree_BPlusTree_Demo.html
图状结构
分为:有向图、无向图
节点的度数 = 入度 + 出度
入度:指向当前节点的边的数量 出度:当前节点指向其他边的数量
图的存储
邻接矩阵
有向图:若节点1 连接 节点 2 ,则在矩阵中,第一行第二列标记为1 a[ 1 ] [ 2 ] = 1
无向图:若节点 1和 2相连,则 a[ 1 ] [ 2 ] = a[ 2 ] [ 1 ] = 1 对称性
若边带有权值 , 则在矩阵中 相连的边 设置为他们边的权值
即若1 、2节点相连,且 且边12所带权值为5,则 a[1] [2] = 5;
若是两个点之间不存在链接,将该边设置为正无穷表示
优点:容易判断两个顶点间是否有边,且易计算顶点的度
缺点:统计边的数量效率较低,空间复杂度高,最多点数量不能超1000
int spot1,spot2,val;
int matrix[500][500];
//带权有向图
for(int i=1;i<=n;i++){
    cin >> spot1 >> spot2 >> val;
    matrix[spot1][spot2] = val;
}
邻接表
$O(V + E)$ 空间存图
邻接矩阵唯一,邻接表不唯一
利用链表思想实现
//1、有向图
//遍历每个点的时候,里面都存有长度为n的链表
list<list<int>> graph;  //无权图
//空间上一开始链表都是空的,不占用空间,随着边的增加,空间开始增加

list<list<int[]>> graph; //带权图
相当于每次增加边时,都增加一个小数组,第一个值为要去的点,第二个值为权值

//2、无向图 == 特殊的有向图
将值加入对称的两条边,和邻接矩阵类似
//建图操作 -- 邻接表
struct Edge{
    int u,v,val;
    Egde *nex;
}epool[10001];
struct node{
    Edge *fir;  //出边链表的第一条边
}nodes[10001];
int k = 1; //从下标1的点开始记录
void add(int u,int v,int val){
    epool[k].u = u;
    epool[k].v = v;
    epool[k].val = val;
    epool[u].nex = nodes[u].fir;    //在一个点对应多条边时,指向之前插入的边的地址
    nodes[u].fir = &epool[k];     //更新边的地址,准备为下一条边赋值
    k++;
}
int main(){
    int n,m;
    cin >> n >> m;
    for(int i = 1; i <= m; ++i) {
        cin >> epool[i].u >> epool[i].v >> epool[i].val;
        add(u,v,val);
        //无向图
        add(v,u,val);
    }
    //遍历图
    Edge *e = &epool[id]; 遍历哪个顶点指向的边集
    while(e != nullptr) {
        cout << ......
        e = e->nex;
    }
}
链式前向星
链式前向星可以试着想象把邻接表顺时针旋转90度,然后把每个点下面挂着的动态数组想象成一个链表结构,结合给边编号的操作(输入时的顺序编号),head数组存的就是每个节点第一条边编号,也就是链表的头节点,然后next数组用来存放每条边的下一条边编号,也就是链表节点的next节点,直到遍历到0号边,相当于链表的nullptr,表示结束位置。然后每增加一条新的边,相当于找到每个节点的链表进行头部插入,将原来的头节点放到新的头节点的next里,然后把新的头节点挂到头上。
本质:模拟链表,采用头插方法,以边为单位,记录每一条边的目标点,包含有head和next头和边数组
以某个节点为起始节点的所有关联有向边的头插法
int head[N]; // 存储以i为起点的所有边的起始位置
int cnt = 0; // 记录边的数量
struct node {
	int to;    // 第i条边的终点
    int w;     // 第i条边的权值
    int nxt;   // 与第i条边相连的下一条边的位置
}edge[N];   //边数组

int add(int u,int v,int w){
    edge[cnt].to = v;
    edge[cnt].w = w;
    edge[cnt].nxt = head[u];
    head[u] = cnt++;
}

图的遍历
BFS、DFS
void dfs(){
	// 递归出口
    // 枚举调用自身,遍历所有情况
}
拓扑排序
源点:入度为0的点,在图中唯一; 汇点:只有一个出度为0的点
关键路径
哈希表
(1)、哈希地址:逻辑地址 <—- 哈希函数
(2)、哈希函数:由用户自己决定(取余法、直接定值法、平方取中法、折叠法【字符串】)
(3)、哈希冲突:哈希值相同时称为哈希冲突
哈希冲突解决方法:开放地址法、邻接表法
1、取余法
// 哈希函数
H(key) =  key % p  ;p: 最大容量
eg:
以一个最大容量p = 7 的数组为例 a[0-6]
给出一组数据  a = [4,88,12,48,34,56]
H(a[i]) = ... ;  // 将算出的逻辑值放在对应数组下标下
H(4) = 4 % 7 = 4;
H(88) = 88 % 7 = 4;  // 哈希值相同时称为哈希冲突
//开放地址法
若哈希冲突,去其他空的地址下插入冲突的key
//邻接表法
在冲突的哈希地址下,建立一个链表
2、直接定值法
// 数据 = 地址 (较为浪费空间 数据最大需要开多大数组)
STL
字符串
常用string函数:length、size、push_back、append、find、substr(pos,len)截取、insert(index,str)、erase(index,count)、replace(first,last,str)、empty
(1)find 函数使用
| 原型 | 说明 |
|---|---|
size_t find(const string& str, size_t pos = 0) const; | 查找子串 str,从 pos 开始 |
size_t find(const char* s, size_t pos = 0) const; | 查找 C 风格字符串 s |
size_t find(const char* s, size_t pos, size_type n) const; | 查找 s 的前 n 个字符 |
size_t find(char ch, size_t pos = 0) const; | 查找单个字符 ch |
(2)substr函数使用
basic_string substr(size_type pos = 0, size_type count = npos) const;
| 参数 | 类型 | 含义 |
|---|---|---|
pos | size_type | 起始截取位置的下标(从 0 开始计数)。默认值为 0 |
count | size_type | 要截取的字符数量(长度)。默认值为 npos |
(3)getline 函数
// c++ 风格的函数,归属 <string>,可以指定输入方式,如 cin  标准输入等
// 形式 (1):使用默认分隔符 '\n'
istream& getline(istream& is, string& str);
// 形式 (2):显式指定分隔符 delim
istream& getline(istream& is, string& str, char delim);
//基础拼接
string s="";
s = s + "abc";   // s="abc"
//1、字符串切割   s.substr(p,n) :表示从s[p]开始往后截取n个字符,n可省略表示截取到最后
string s1("hello world!");
cout<<s1.substr(6,5);

//2、字符串查找   s.find(b,p) : 表示在字符串s中从p开始向后查找字符串b
//找到返回b的首字符地址,否则返回-1,p可省略表示从头开始查找
int p=s1.find(s2);

//3、字符串翻转  reverse(s.begin(),s.end());
string s2("abc");
cba;  // 输出

//4、插入字符
string s("ade");
s.insert(1,"bc");

int num = stoi(s);  // 将字符串转换成数值类型数据
reverse(s.begin(),s.end());  // 倒置字符串
vector容器
一维vector
#include<iostream>
#include<vector>
typedef struct{
	char company_name[100];
    double pizza_d;
    double pizza_weight;
}Piza;
int main(){
    vector<int> vi(4,10); //第一个参数申请的数组长度,第二个参数每个位置的元素赋初值10
    vector<int> vii(vi.begin(),vi.end());
    //1、添加元素
    vi.push_back(值);  //向vi[0] 赋值,尾插
    vi.insert(vi.begin(),4,2);  // 从vi开始的位置插入4个2
    //2、删除元素
    vi.pop_back()    //删除最后一个元素
    vi.erase(vi.begin()+i,vi.begin()+j)  //删除区间[i,j-1] 元素
	//3、访问元素
    vi.front() //访问第一个元素
    vi.back()  //访问最后一个元素
    //4、查找函数
    find(vi.begin(),vi.end(),x)  //x为需要查找的值
    }
    vector<Piza> arr(5);   //利用vector容器技术申请的结构体数组
// resize
// 1. 将容器大小调整为 count
void resize(size_type count);

// 2. 将容器大小调整为 count,新增的元素初始化为 val
void resize(size_type count, const value_type& val);
// v.unique(st, end);  工作机制
// 注:unique必须在整体有序的情况下使用
vector<int> a1;
a1 = [1, 2, 2, 3, 3, 5];  // 使用前
a1 = [1, 2, 3, 5, x, x];  // 使用后,返回值指针指向倒数第二个数,x(从这个数往后都变成无效值)
// 配合 v.erase(st,end);  删除左闭右开 [st , end) 元素
a1.erase(unique(a1.begin(),a1.end() ), a1.end());
二维vector
//创建二维数组
vector<vector<int>> matrix(3,vector<int>(3)) //创建3*3矩阵
for(int i=0;i<matrix.size();i++){    //二维vector行长度
    for(int j=0;j<matrix[i].size();j++) //获取二维vector的列长度
}
vector 操作
//1、复制与赋值
    //一个vector被赋值或复制时,会创建一个新对象,将所有元素深拷贝,对新vector修改不影响原来的vector
    vector<int> vec1 = {1,2,3};
	vector<int> vec2 = vec1;  //深拷贝
	vector<int> vec3 = move(vec1) //利用move(c++11开始)不用进行深拷贝,直接赋值
}
//2、查找最大元素
	int maxn = vec1.max_size();

//3、去重操作
vector<int> vec = {1,1,2,3,3,4};
vec.erase(unique(vec.begin(),vec.end()),vec.end());

//4、二分查找
//在这个区间上查找>=value的数,返回的是一个指针(迭代器)
lower_bound(起始位置,结束位置,value);
vector<int> vec = {3,7,2,9,11,8,15};
sort(vec.begin(),vec.end());
int t = lower_bound(vec.begin(),vec.end(),7); //查找第一个>=7的数
int t1 = upper_bound(vec.begin(),vec.end(),7); // 查找第一个 >7 的数
反向迭代器的使用
vector<int> ans;
auto last = find(ans.rbegin(),ans.front());  // 从尾部到头部查找第一个=ans.front() 的元素
// last 为反向迭代器,查找到的最末尾的元素
last.base()   // 将反向迭代器转为正向迭代器
// 公式 last = last.base - 1 即 last.base 迭代器指向原来迭代器后面一个元素
sort 接口函数
#include<algorithm>   //包含sort函数的头文件
typedef struct
{
    int a,b;
}node;
node pre[3];
bool cmp(int x,int y){
	return x>y;
}

bool copm(const node &x,const node &y){
    return x.a>x.a;
}

int main()
{
    int arr[5]={5,2,4,1,3};
	//第一个参数要排序的数组首地址,第二个参数要排序的数组尾地址,第三个参数,排序的方式
	sort(arr,arr+4,...) ;
    sort(arr+1,arr+4,cmp);   //按照  x>y的值来进行排序
    sort(pre,pre+3,comp);    //结构体数组 按其中某个成员之间的大小排序
}
运算符重载
在c++中,运算符重载本质上是定义一个函数,告诉编译器当运算符作用于结构体或类时,应该执行什么操作
不能重载的运算符: . 成员运算符、 :: 域运算符、 * 、-> 成员指针访问运算符、sizeof 长度运算符、?:条件运算符、预处理运算符 #
**仿函数:**如果类重载了operator 运算符,则这个类(结构体)可以称作仿函数
重载运算符函数可以对运算符作出新的解释,但原有基本语义不变:
1、不改变运算符的优先级 2、不改变运算符的结核性
3、不改变运算符所需要的操作数 4、不能创建新的运算符
//语法1:作为结构体的成员函数(常用),左操作数是 this,右操作数是参数
返回类型  类名::operator 运算符 (参数列表)const{   // const 代表操作不改变他原本的值
    对应运算符的操作
}
重载 < 运算符(最常用)
struct node{
    int a,b;
    int idx;
    bool f;
    bool operator<(const node& x) const {    // A& x 引用传参,避免拷贝,const代表只读
        if(a == x.a) {           // 末尾的const 表示不会修改this指向的对象
            return b > x.b;
        }
        return a < x.a;
    }
};
重载括号运算符
//结构体当作类,在c++中结构体默认是公有的
struct node{
    void operator()(int a,int b){
        return a>b;
    }
}
int main(){
    int a= 1,b=2;
    node();//是一个匿名对象 ,定义一个对象
    node val;
    val(2,2);    //调用重载函数
    //还可以 这样调用
    node()(a,b);    前面是一个匿名对象调用该重载函数
}
GCD–LCM
int gcd(int a,int b){
    return a%b?b%(a%b):b;
} //__gcd();

int lcm(int a,int b){
    return a/gcd(a,b)*b;    //原式 = a*b/gcd(a,b);  但是a*b可能出界
}
栈和队列
stack一种FILO(first in last out)(先进后出)的数据结构
#include<bits/stdc++.h>
#include<stack>
int main(){
    stack<数据类型> stk;
    stk.push(x);    //压入栈

    //必须保证栈非空,否则会报错(RE)runtime error
    stk.pop();     //将栈顶弹出
    stk.empty()    //判断栈是否为空,不为空返回true,否则返回false

    int T = stk.top();   //返回栈顶的元素,返回类型取决于定义类型

    for(int i=1;i<=5;i++) stk.push(i);
    while(!stk.empty()){
        cout<<stk.top();    //将栈顶元素取出
        stk.pop();        //取出后,将栈顶元素出栈
    }
    结果:54321
    return 0;
}
队列
1、普通队列
#include<bits/stdc++.h>
#include<queue>
int main(){
	queue<int> q;
    q.push(值)   //将值插入队列中
    q.pop()     //将队列中 队头元素出队(移除队头元素),并不输出
    q.front()   //返回队头元素,但不移除
    q.back()    //返回队尾元素,不移除
    q.empty()   //判断队列是否为空,不为空返回true,否则返回false
    for(int i=1;i<=5;i++){
		q.push(i);
    }
    cout<<q.front();
    q.pop();
    cout<<q.front();
	//输出:12

    ***
    //用队列将2个以上元素打包为一个元素
    queue< pair<int,int> > q; 或者 typedef pair<int,int> P; queue<P> q;
    //x = q.front().first   存储坐标x
    //y = q.front().second  存储坐标y
    ***

    将元素存入队列
    q.push(make_pair(x,y)); 或者  q.push({x,y});
}
2、双端队列 deque
介绍:给定一组序列,$[\;a_1,a_2,a_3 \cdots a_n\;]$ ,对于双端队列,可以分别在队头、队尾进行插入和删除操作
- 输入受限:限制单侧插入,不限制删除操作(两端都可以删除)
- 输出受限:限制单侧删除,不限制插入操作(两端都可以插入)
应用:模拟栈、滑动窗口、撤销/重做、任务调度
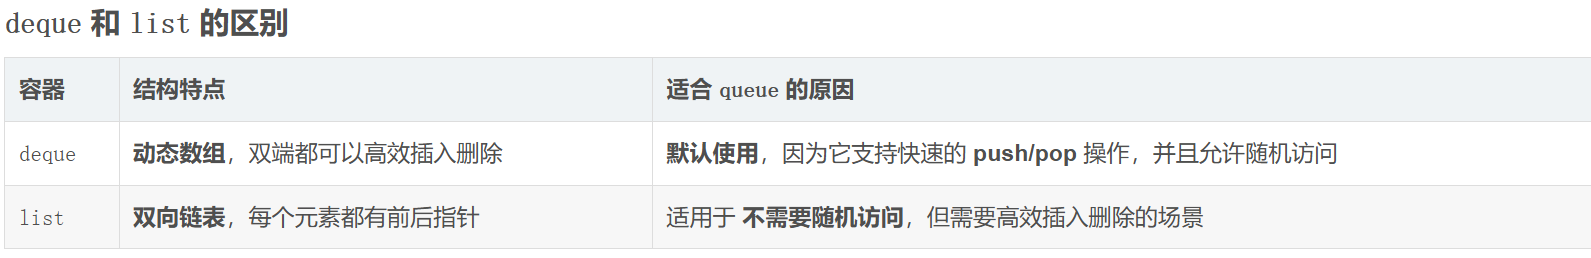
// queue的底层容器是deque,但可以更改为list(queue也可以使用list)
queue<int,deque<int>> q;  <==> queue<int,list<int>> q;
//deque操作
deque<int> dq;
1、dq.push_front(值);    //  首插
2、dq.push_back(值);     // 尾插
3、dq.pop_front();      // 删除队头元素
4、dq.pop_back();       // 删除队尾元素
dq.front();         //获取队头元素
dq.back();         //获取队尾元素
dq.size();     //计算元素个数
dq.empty();    //判空
3、优先队列 priority_queue
介绍:优先队列本质是用数组实现的堆(完全二叉树),可以拿出优先级最大的元素
大顶堆:值越大的元素优先级越高
小顶堆:值越小的元素优先级越高
priority_queue<int> que;  //默认大顶堆
que.size();
que.push(x);   //插入x
que.pop();     //删除优先级最高的元素

que.top();     //访问优先级最高的元素,堆顶元素
que.empty();  //判空
//第一个参数表示存储的参数类型
//第二个参数表示所用的容器
//第三个参数是(仿函数) 比较方法  less<int> 大顶堆    greater<int> 小顶堆
priority_queue<int,vector<int>, greater<int>> que;
struct node{
    int x,y;
    bool operator < (const node &b) const{
        return this->x < b.x;    //重载小于号less,大的数还是优先级高;若重载大于号,小的数优先级高
    }
};
priority_queue<node> que;
que1.push({1,2});
que1.push({9,-1});

while(!que.empty()){
	cout<< que.top().x << endl;
    que.pop();
}
集合 set
底层结构红黑树,有序,无重复,不支持随机访问[],插入删除复杂度 $O(logn)$
#include<set>
set<int> p;
p.empty();
p.size();
p.insert(value);
p.erase(value);
multiset
基于红黑树实现,有序,有重复,插入删除复杂度 $O(logn)$
#include<set>
multiset<int,greater<int>> ms; // 指定降序
ms.insert(x);    // 插入
ms.erase(x);     // 删除
// 遍历,访问,不允许 ms[i] 取值
for(auto i = ms.begin(); i != ms.end(); ++i){
    cout<< i << " ";      // 迭代器实现访问
}
for(auto& i : ms){  cout<< ms << " ";}
//二分查找
ms.lower_bound(v);  //第一个 >= 元素的迭代器
ms.upper_bound(v);  // 第一个 > 元素的迭代器
// 只有当 v 大于容器中所有元素时,返回 end() 迭代器
键值对 map
#include<bits/stdc++.h>  || #include<map>
map<T_key,T_value> m;
// map : 基于红黑树实现,按键排序,查找效率平均O(logn)
// 自定义类型需要比较时,重载小于号
struct node{
    int x,;
    bool operator < (const node &u) const{
        return x == u.x ? y < u.y : x < u.x;
    }
}
map<node,int> mp;
//常用操作
insert({key,value})
erase(key)
find(key)
operator[key] //返回指定的键值
count(key)   // mp.count(key) 访问该键所映射值的次数
size()    //键值对数
clear()  empty()  begin() end()
//查找key是否存在
map<int,int> mp;
if(mp.find(key) != mp.end()) cout<<mp[key]<<'\n';
if(mp.count(key))  cout<<mp[key]<<'\n';

//遍历map
for(auto &i : mp) {
    cout<< i.first << " " << i.second << '\n';
}
for(auto &[key,val] : mp) {
    cout<< key << " " << val <<'\n';
}
unordered_map
// unordered_map 基于哈希表实现的map集合容器
// 元素无序,查找性能平均O(1),应用于需要快速查找,无序
// 头文件 #include<unordered_map>
unordred_map<string,int> mp;
mp.insert({"Alice",25});   // 增加键值对
mp.emplace("David",32);    //增加,效率更高
mp["Char"]=28;       // 若存在键修改,不存在插入

// 删除
mp.erase("Alice");
// 遍历
for(auto it = mp.begin(); it != mp.end(); ++it){
	cout<<it->first<<" "<< it->second <<endl;
}
mp.empty()     // 判空
mp.size()     // 键的数量
元组 tuple
若元素数超出2个,不想写结构体,可以使用
using node = tuple<ll, int, int>;
 // 建图时
vector<node> e;
// 取值
node a;
get<0>(a);  // 取第1个元素
// 对 tuple 排序,lambda表达式
sort(e.begin(),e.end(),
    [](const node& x,const node& y){
		return get<0>(x) < get(0).y;   // <第n个元素>从0索引开始
    }
);
next_permutatiom
全排列
与其相对应的 prev_permutation
内容介绍:每运行一次就可以排列出下一次的全排列
语法:next_permutatiom(数组开头,数组结尾) 类似于sort
//用法
#include<algorithm>
#include<bits/stdc++.h>
using namespace std;
int a[1000];
int n;
int main(){
	cin>>n;
	for(int i=1;i<=n;i++){
		cin>>a[i];
	}
    //令a[i] = i;
    int tot = n;   //所有全排列的数量

    do{
    	for(int i=1;i<=tot;i++){
    		cout<<a[i]<<" ";
		}
		cout<<endl;
	}while(next_permutation(a+1,a+n+1));
    return 0;
}