基础部分
1.1 MySQL简介
什么叫做数据库(DBS)、数据库管理系统(DBMS)、SQL
| 名称 | 全称 | 简称 |
|---|---|---|
| 数据库 | 存储数据的仓库,对数据进行有组织的管理 | DataBase(DB) |
| 数据库管理系统 | 操纵和管理数据库的大型软件 | DataBase Management System (DBMS) |
| SQL | 操作关系型数据库的编程语言,定义了一套操作关系型数据库统一标准 | Structured Query Language (SQL) |
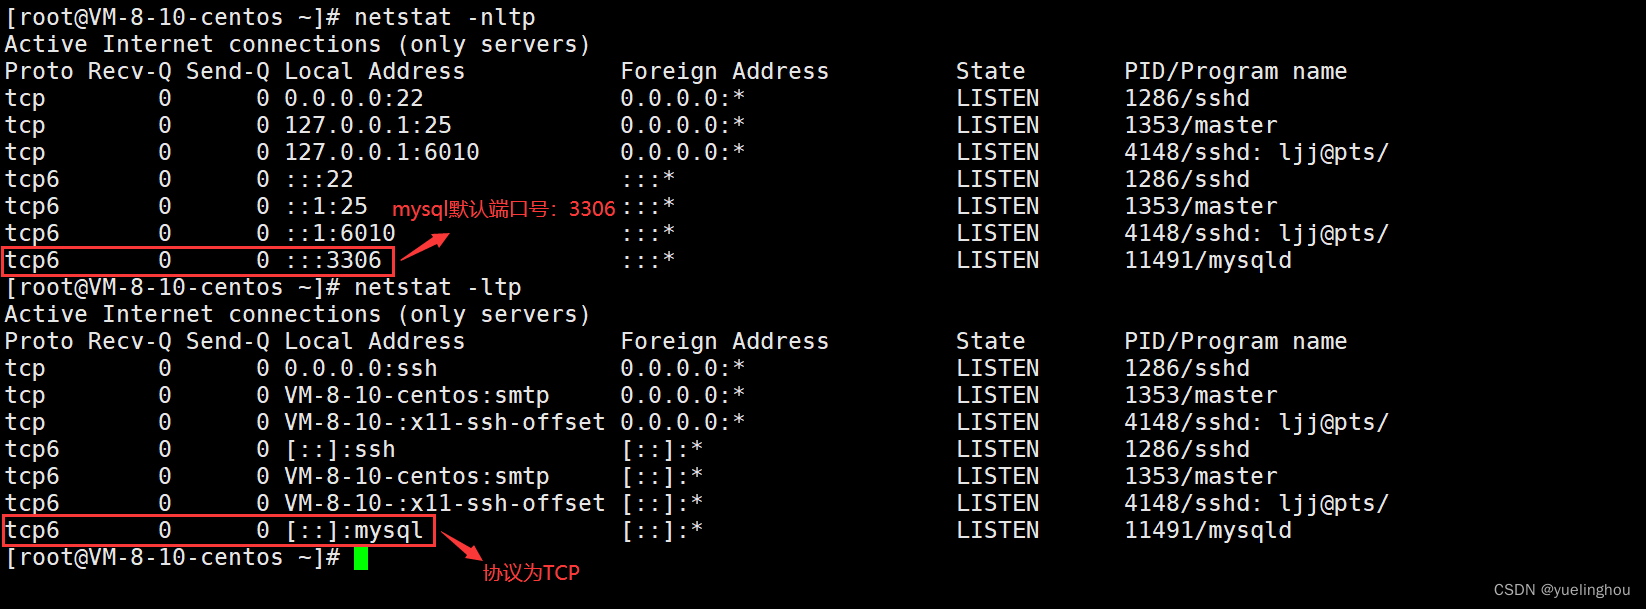
安装MySQL,其实就是在自己的平台上安装 MySQL 的客户端和服务器,更确切的说,该数据库服务的本质是一个网络服务器进程(本质上是一个软件),所以它也应有自己对应的端口号和其所遵守的协议:
服务器,数据库,表关系
- 首先我们需要连接 MySQL 服务器,然后在 MySQL 客户端中输入对数据进行操作的 SQL 语句,并交给服务器端完成。
- 同时我们可以创建多个数据库,为了保存应用中实体的数据,一般会在数据库中创建多张表,以保存程序中实体的数据。
数据库服务连接!!
net start mysql80  # 启动服务
net stop mysql80   # 关闭服务
连接数据库
mysql [-h IP地址] [-P 3306] -u 用户名 -p

-h :Mysql服务所在的主机IP
-u :Mysql数据库用户名
-P :Mysql服务端口号,默认3306
-p :数据库用户对应的密码
查看设置数据库存储路径
# 查看数据库存储路径,进行更改或查看自己的数据库内容
show variables like '%datadir%'
select @@'datadir'
系统数据库介绍
| 数据库 | 含义 |
|---|---|
mysql | 存储MySQL服务器正常运行所需要的各种信息 (时区、主从、用户、权限等) |
information_schema | 提供了访问数据库元数据的各种表和视图,包含数据库、表、字段类型及访问权限等 |
performance_schema | 为MySQL服务器运行时状态提供了一个底层监控功能,主要用于收集数据库服务器性能参数 |
sys | 包含了一系列方便 DBA 和开发人员利用 performance_schema 性能数据库进行性能调优和诊断的视图 |
1.2 数据库查询语言
DDL(存储、维护数据库结构)、DML(维护数据)、DQL(查询数据)、DCL(数据控制,权限和事务,管理数据库及用户)
1.2.1 DDL
DDL【data definition language】: 数据定义语言,用来维护存储数据的结构
代表指令: create、drop、alter
数据库操作的语法
1、查询
/*  查询所有数据库  */
show databases;
/*  查询当前数据库  */
select database();
2、创建
/*  创建数据库  */
create database [if not exists] 数据库名
[default charset 字符集] [collate 排序规则]

/*  创建表   */
create table 表名(字段1[field] 数据类型[type] comment "注释");  //注释可省略
3、删除
/*  删除指定数据库  */
drop database [if exists] 数据库名;
4、使用
use 数据库名;
5、查询当前数据库所有表
show tables;
6、查询表结构
desc 表名;
7、查询指定表的建表语句
show create table 表名;
8、修改表结构,更改字段
/*1、增加字段*/
alter table 表名 add 字段名 类型(长度) [comment 注释][约束];
/*2、修改数据类型*/
alter table 表名 modify 字段名 新数据类型(长度);
/*3、修改字段名和字段类型*/
alter table 表名 change 旧字段名 新字段名 类型(长度) [注释][约束];
/*4、删除字段*/
alter table 表名 drop 字段名;
/*5、修改表名*/
alter table 表名 rename to 新表名;
数据类型
/*     数字类型      */
tinyint :字节
smallint : 短整型
mediumint :占用3字节
int / integer : 整型4字节
float : 单精度4字节
double : 双精度8字节
decimal(小数的,十进制数的) :
/*    字符串类型   */
char : 1字节 (0-255)
varchar : 0-65535 ( 变长字符串)
# 日期时间类型字段
date 只包含年月日
datetime  包含年月日 时分秒
运算符使用
in and or not <> like [%:匹配0或多个字符] [between and]
| 名字 | 描述 |
|---|---|
| <> , != | 不相等运算符 |
| <=> | NULL安全等于运算符 |
| is NULL | NULL 值测试 |
| between …… and …… | 值是否在范围之内 |
| not between and | 值是否不在范围之内 |
in() | 区间取值 |
1.2.2 DML
DML【data manipulation language】 :数据操纵语言,用来维护数据本身
代表指令: insert、delete、update
update 表名 set [字段] where ...
delete from [表名] where 条件
insert into [表名](字段列表,可省略代表全字段插入记录) value(记录值)  # 插入单条记录
insert into [表名](字段列表,可省略代表全字段插入记录) values(记录值) # 插入多条记录
1.2.3 DQL
DQL【Data Query Language】:数据查询语言,用来查询数据库中表的记录
select distinct……[as 别名] from 表名 where …… group by 分组字段列表 having 分组后条件列表
order by 排序方式 (asc升序 desc 降序) limit 分页参数(起始索引,每页展示记录数)
-- 起始索引 = (页码 - 1)* 每页展示的记录数
# 去重查询
select distinct [字段列表] from 表名;
联合查询:将多个表的查询结果拼接在一起,形成一个新的查询结果集
- 对于联合查询的多张表的列数必须保持一致,字段类型也需要保持一致。
union all会将全部的数据直接合并在一起,union会对合并之后的数据去重。
# union all 不会删除重复记录
select 字段列表 from 表1……
union [all]
select 字段列表 from 表2……;
分页查询
select 字段列表 from 表名 limit 起始索引,查询记录数;
从第一页开始查询,起始索引可以省略
# 查询前多少条记录
select 字段列表 from 表名 limit 要取的数量 offset 要跳过的数量
子查询
1、列子查询:查询结果返回一列或多列
常用操作符:in、not in、any(任意一个满足)、some(与any一致)、all(列表所有值都满足)
2、行子查询:查询返回结果是一行或者多行
3、标量子查询
# 查询薪资 和 领导id一致的员工信息
select * from emp where (salary,managerid) = (select salary,managerid from emp)
多表查询
表结构之间的关系:一对多(多对一) ,多对多, 一对一
是员工表emp所有的记录 (17) 与 部门表dept所有记录(6) 的所有组合情况,这种现象称之为笛卡尔积。
即所有的记录数为: $17 \times 6 = 102$
笛卡尔积: 笛卡尔乘积是指在数学中,两个集合 A 和 B 的所有组合情况
一对一:一个表中字段作为另一个表中的外键,且这个字段为唯一(唯一:字段不重复)
一对多:设置一个表中字段作为另一个表中的外键
多对多:通过建立第三张表分别令第三张表字段作为其他表的外键,以此建立对两张表的约束关系
连接查询:内连接、外连接 以及 子查询
(1)内连接:相当于查询 A、B 交集部分数据
分为:隐式内连接、显式外连接
1、隐式内连接
 SELECT  字段列表   FROM   表1 , 表2 [别名]  WHERE   条件 ... ;
2、显示内连接
 SELECT  字段列表   FROM   表1  [ INNER ]  JOIN 表2  ON  连接条件 ... ;
(2)外连接:左连接、右连接、自连接
左:查询左表所有数据,以及两张表交集部分数据
右:查询右表所有数据,以及两张表交集部分数据
自连接:当前表与自身的连接查询,自连接必须使用表别名(可以是内连接查询,也可以是外连接查询。)
select 字段列表 from 表1 left [outer] join 表2 on 条件……; #左外连接
select 字段列表 from 表1 right [outer] join 表2 on 条件……; #右外连接
(3)子查询
概念:sql语句中嵌套CRUD语句,称为嵌套查询,又称子查询(子查询外的语句可以是增删改查任意一个).
标量子查询:查询结果为单个值,常用操作符(
<> = > <)列子查询:结果为一列(
in、 not in、 any、 some、 all)行子查询:结果为一行(
= 、<> 、in 、not in)表子查询:结果为多行多列
分类:where之后出现的子查询、from之后出现、select之后出现
#1、where 之后出现的子查询
select name, age, job from emp where salary > (select avg(salary) from emp);

#2、from 之后出现的子查询
-- 查询入职日期在 2006/1/1 之后的员工信息,及其部门信息
select e.*,d.*
from (select * from emp where entrydate > '2006/1/1') e left join
    dept d on e.dept_id = d.id;

#3、select 之后出现的子查询
select (select name from emp where salary > 10000) from emp……;
1.2.4 DCL
DCL【data control language】:数据控制语言,主要负责权限管理和事务,管理数据库用户、控制数据库的访 问权限。 代表指令: grant、revoke、commit
/*  创建用户 */
主机名默认是localhost
create User '用户名'@'主机名' identified by '密码';
任意主机可以访问该用户
create user '用户名'@'%' ……
修改用户密码
alter user '用户名' @'主机名' identified with '新密码';
删除用户: drop user '用户名' @'主机名';
权限控制
1、授予权限
grant 权限列表  on 数据库名.表名 to '用户名' @'主机名';
2、查询权限 show grants for '用户名' @'主机名';
3、撤销权限 remove 权限列表 on 数据库名.表名 to '用户名' @'主机名';
/*  授权时,可用*代替数据库名和表名  */
1.3 MySQL常用函数
MySQL中的函数主要分为以下四类: 字符串函数、数值函数、日期函数、流程函数,另有聚合函数,窗口函数
/*字符串函数*/
拼接 concat(s1,s2……);
左填充 lpad(str,n,pad); 用pad对str的左边进行填充,达到n个字符串长度
去掉字符串头部和尾部空格 trim(str);
substring(str,start,len);  返回字符串从start开始的len个字符长度
substring_index(要截取的字段名, '分割符' , pos截取位置) # pos:1左侧开头开始,-1右侧开始
/*数值函数 */
ceil(x) 向上取整
floor(x) 向下取整
round(值,保留小数位数);
/*日期函数*/
day(date);  获取日期
month(date) : 获取月份 year(date):年份
curdate() : 返回当前日期
now()    : 返回当前日期和时间
#向日期添加指定的时间间隔
date_add(date,interval expr type) date:日期表达式,expr:时间间隔 ,type:时、秒、分、日、月……

datediff(date1,date2); 返回d1和d2之间的日期差
/*流程函数*/
if(value,t,f); 正确返回t,错误返回f
ifnull(v1,v2); 不为空返回v1,否则v2
case 字段 when 过滤 then 否则是...
流程控制函数
# if(value,t,f) : 如果value为true 返回t,否则返回f
# ifnull(value1,value2) : 如果value 不为空返回value1,否则value2 【类似三目运算符】
# case when then语句
-- (1)
case
	when age is null then '其他'   # 每一次选择when后无 ,
	when age < 20 then '...'
	when ……
end as age_cnt [将上述语句 判断完记录的值新建字段存入]

-- (2)
case 字段
	when result1 then ''
	when result2 then ''
	else ''
end as '' 别名字段
聚合函数
之前所使用的查询大多数都是横向查询,它根据条件一行一行的进行判断,而使用聚合函数进行查询是 将一列数据作为一个整体,进行纵向计算,常搭配as对查询出的数据进行重命名,null值不被聚合函数所计算
常见聚合函数:count、max、min、avg、sum……
where不能对聚合函数进行判断(因为聚合函数所统计出的是一个数据,进行判断没有意义),而having是分组之后的结果,是多组数据,可以再次进行过滤筛选,比如说分组过后仍然存在多组数据,再进行条件过滤进一步在分组的条件上,筛选出符合条件的数据.
select [count(字段名) | max() | avg() | sum()……] from 表名
窗口函数
也被称为分析函数,处理相对复杂的报表统计分析场景
什么叫做窗口?可以理解为记录集合,窗口函数也就是在满足某种条件的记录集合上执行的特殊函数。
对于每条数据都要在此窗口内执行函数,窗口的大小都是固定的,这种属于静态窗口; 而不同的记录对应不同的窗口,这种叫做 滑动窗口
# 基本语法
函数名([expr]) over子句
其中,over是关键字,指定函数执行的窗口范围,包含三个分析子句,分组partition by、排序oerder by、窗口row,若over()
括号中什么也不写,则窗口包含满足where条件的所有行,窗口函数基于所有行计算
函数名([expr]) over(partition by <要分的组> order by <要排序的列> rows betewwn <数据范围>)
# 对于数据取值的解释,演示
rows between 2 proceding and current row  # 代表取当前行和前2行
rows between unbounded prodeding and current row   # 取当前行和之前所有行 unbounded:无限的
rows between n proceding and m follwing     # 取前n行,下m行,共m+n行

-- 若 缺少窗口子句,默认 rows between unbounded prodeding and current row
-- 若少 order by 和 窗口子句,默认 rows between unbounded proceding and unbounded follwing
窗口函数一般可以分为两种:专有窗口函数、聚合类窗口函数
-- 1、专有窗口函数
rank() 、dense_rank() 、row_number()、ntile(n)
-- row_number(),生成行的编号
-- rank() ,      生成排名,根据生成的编号,比如前3条数据排名一致,则为1,第4条排名则为4(跳跃排序)
-- dense_rank(), 生成排名,根据实际的排名1,2,3……(连续排序)
-- ntile(n)  , n为切分的片数,即将所有记录平均分成n片,适用于 将各个阶段的记录编号,或者取前xxx的数据
-- 2、聚合类窗口函数
sum() 、 count() avg() ……
普通场景下,聚合函数和group by 一起使用,在窗口环境下,聚合函数也可以使用,这时被称为 聚合类窗口函数
和 聚合类窗口函数 不同的是,窗口函数每条记录都会执行,即执行过后记录数和执行前一样
1.4 字段约束
非空约束:值不能为null
唯一约束:数据唯一,不能重复
主键约束:一行数据的唯一标识,要求非空且唯一
默认约束:保存数据时,如果未指定字段值,采取默认值
检查约束:保证字段满足某个条件
外键约束:用来让两个数据表建立连接,保证数据的一致性和完整性
约束是作用于表中字段上的,可以在创建表/修改表的时候添加约束。
/* 约束的类型 */
1、 not null # 非空约束
2、 unique   # 唯一约束
3、 primary key #主键约束
4、 check     # 检查约束
5、 foreign key # 外键约束
/*外键约束 -- 操作  */
# 1、已建表,添加外键约束
alter table 表名 add constraint(约束,限制) 外键名称 foreign key references(关联,提及) 主表字段名
# 2、创建表时:
create table 表名{
	字段 数据类型,
	……
	[constraint] 外键名称 foreign key 外键字段名 references 主表字段
};
删除/更新行为:在添加外键之后,删除父表数据时产生的约束行为
1、no action   /*当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,
                     如果有则不允许删除/更新。 (与 RESTRICT 一致) 默认行为  */

2、restrict	  /*  当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则不
                 允许删除/更新。 (与 NO ACTION 一致) 默认行为 */

3、cascade   /*当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有,则
						也删除/更新外键在子表中的记录。*/
4、set null      /* 当在父表中删除对应记录时,首先检查该记录是否有对应外键,如果有则设置子表
				中该外键值为null(这就要求该外键允许取null)。 */
5、set default     /* 父表有变更时,子表将外键列设置成一个默认的值 (Innodb不支持) */
1.5 事务操作
概念:一组操作的集合,是一个不可分割的工作单位,事务会把所有的操作作为一个整体一起向系统提交或撤销操作请求,即这些操作要么同时成功,要么同时失败.
事务操作过程:
1、开启事务
2、如果执行过程中,代码抛出异常,则回滚事务
3、提交事务
MySQL的事务默认自动提交,执行一条DML操纵(增删改)语句,立即隐式的提交事务
-- 事务操作方式
1、是否开启事务操作
2、更改事务提交方式
#事务操作
-- 1、查看/设置事务提交方式
select @@autocommit;
set @@autocommit=0;   设置为手动提交
-- 2、开启事务
start transaction(begin);
begin ;     # 另一种简便方式
-- 3、提交事务
commit;
-- 4、回滚事务
rollback;
事务四大特性(ACID):
1、原子性:事务不可分割,全成功或全失败(A)
2、一致性:事务完成,数据必须保持一致状态(C)
3、隔离性:数据库系统提供的隔离机制,保证事务在不受外部并发操作的环境运行(I)
4、持久性:事务提交或回滚,对数据改变是永久的(D)
并发事务问题
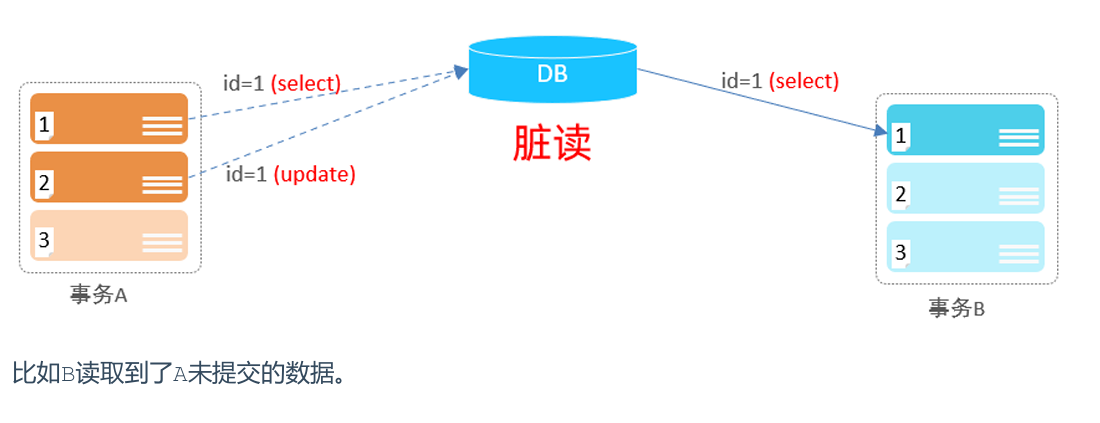
1、脏读:一个事务读取到另外一个事务还没有提交的数据
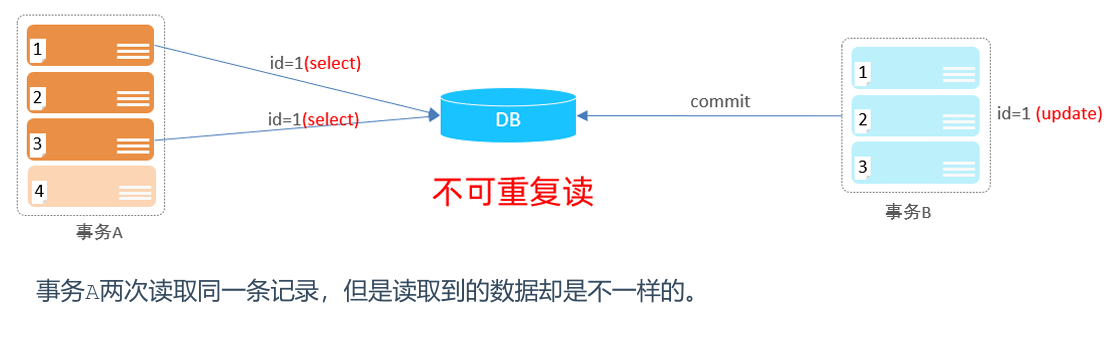
2、不可重复读:一个事务先后读取同一条记录,但两次读取的数据不一致
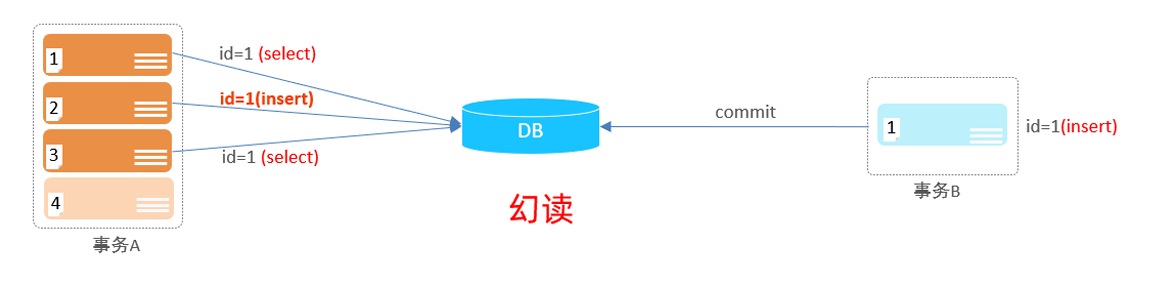
3、幻读:一个事务按照条件查询数据时,没有对应的数据行,但是在插入数据时,又发现这行数据已经存在,好像出现“幻影”
-- A事务还没完全执行完成,未提交,B读取到了A还没有提交的数据(脏读)
-- A事务正在执行select语句,B事务同时更新数据,并进行提交,然后就发生A前后读取不一致
-- A事务先进行查询id为1的语句,未查找到,B事务同时进行插入id为1的数据,然后A事务再次进行插入id=1数据,插入失败,再次进行查询id=1数据仍无法找到
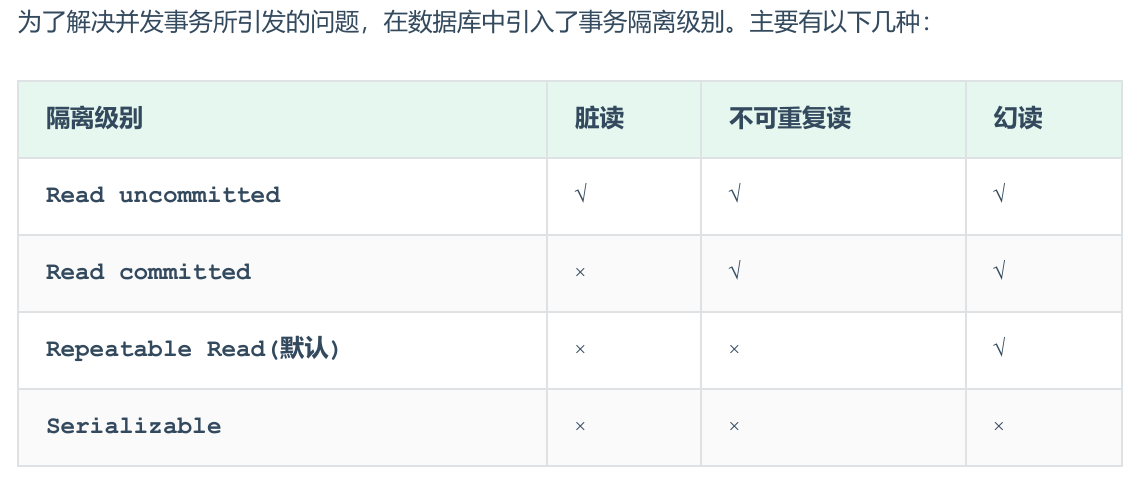
事务隔离级别
-- (RU) Read uncommitted 读未提交 脏读、不可重复读、幻读d都会出现
-- (RC) Read committed   不可重复读、幻读会出现
-- (RR) Repeatable Read(Mysql默认隔离级别) 幻读会出现
-- (S)  Serializable     都不会出现

1、查看事务隔离级别
select @@transaction_isolation;  查看@@(系统变量信息)
2、设置事务隔离级别
set [session(会话级别,仅在当前窗口有效)/ global] transaction isolation level
[read ……]
# 事务隔离级别越高,数据越安全,但是性能越低。
用户权限管理
用户管理
MySQL 是多用户的数据库系统,按权限分为两种:root,超级管理员,和由root用户创建的普通用户
# 创建用户
create user username identified by 'password';
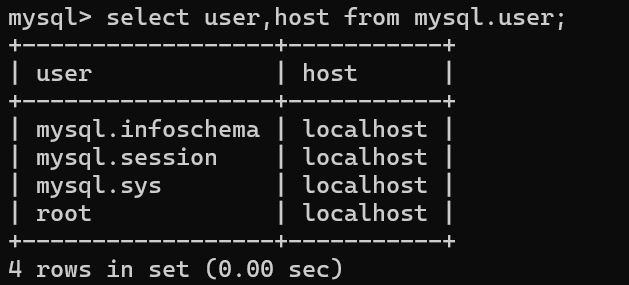
# 查看用户
select user ,host from mysql.user;
权限管理
新用户创建完后无法登录,需要分配权限
grant 权限 on 数据库.表 to 用户名@主机名 identified by 'password'
登录主机:
| 字段 | 含义 |
|---|---|
| % | 匹配所有主机 |
| localhost | localhost 不会被解析成 IP 地址,直接通过 UNIXsocket 连接 |
| 127.0.0.1 | 会通过 TCP/ IP 协议连接,并且只能在本机访问 |
| ::1 | 兼容 ipv6 版本的,表示同 ipv4 的 127.0.0.1 |
权限列表:
| 权限 | 作用范围 | 作用 |
|---|---|---|
| all [ privileges ] | 服务器 | 所有权限 |
| select | 表、列 | 选择行 |
| insert | 表、列 | 插入行 |
| update | 表、列 | 更新行 |
| delete | 表 | 删除行 |
| create | 数据库、表、索引 | 创建 |
| drop | 数据库、表、视图 | 删除 |
| shutdown | 服务器 | 关闭服务 |
| process | 服务器 | 查看进程信息 |
| reload | 服务器 | 允许使用 flush 语句 |
| file | 服务器 | 文件操作 |
| grant option | 数据库、表、存储过程 | 授权 |
| references | 数据库、表 | 外键约束的父表 |
| …… | …… | …… |
# 示例:为 u_sxt 用户分配只能查询 tlias库中的emp表,并且只能在本机登录的权限,密码为:yyy
grant select on tlias.emp to u_sxt@'localhost' identified by 'yyy';
刷新权限
每当权限调整后,需要刷新权限,保证新权限的正常运行
flush privileges;
删除用户
drop user username@localhost;
存储引擎
2.1 MySQL体系结构
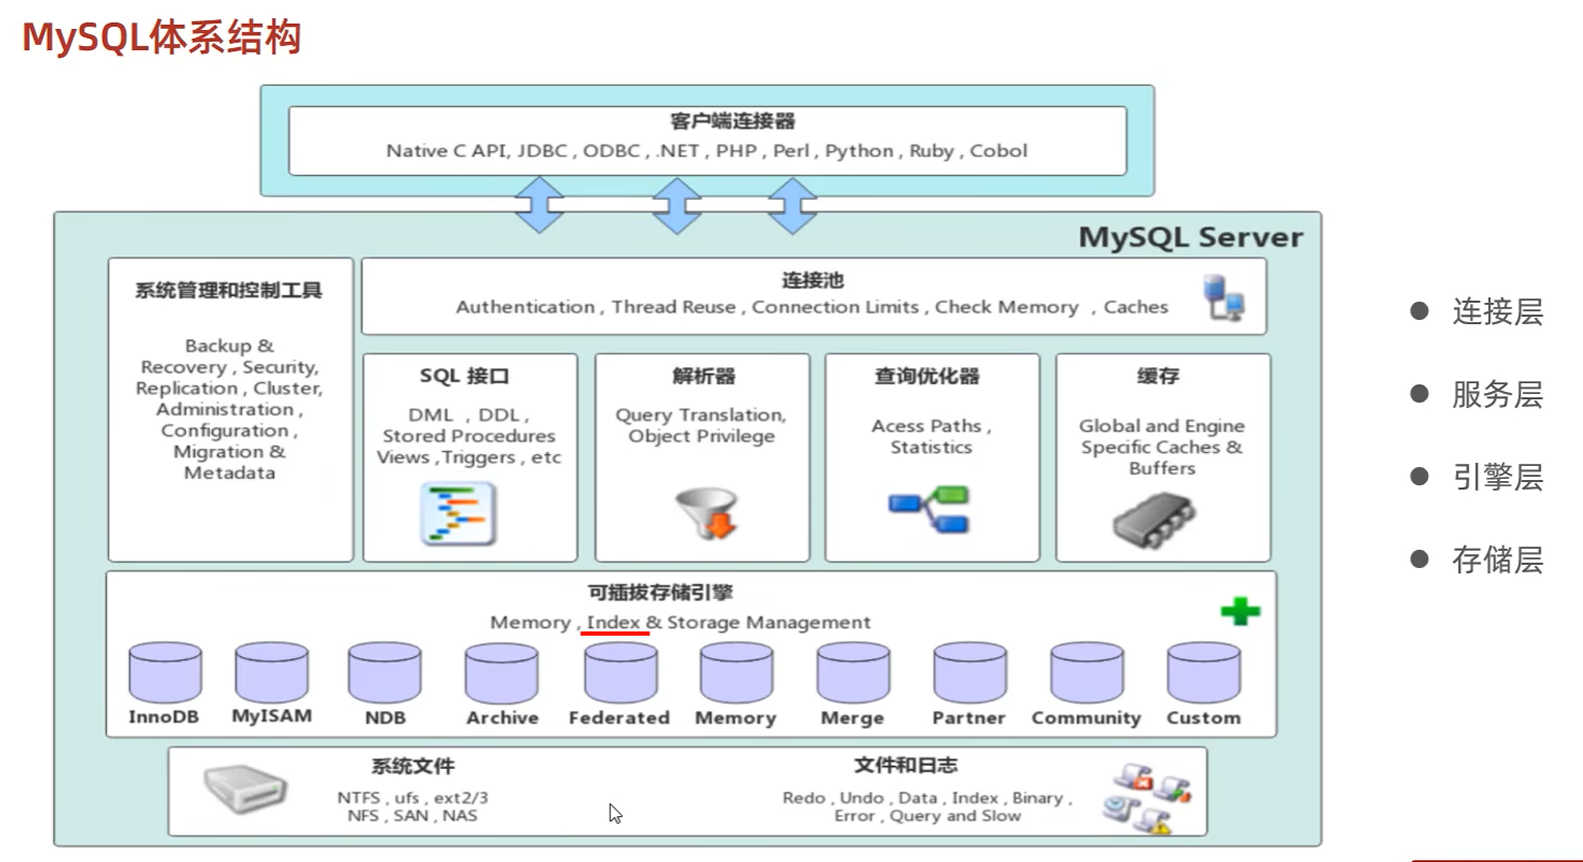
1、连接层:是一些客户端和链接服务,主要完成类似链接处理、授权认证、及相关安全方案校验用户名。服务器也会为安全接入的每个用户验证它具有的操作权限
2、服务层:大多数的数据库服务都在这一层完成
3、引擎层:存储引擎控制数据的存储方式,数据库服务器通过API 与其进行交互,不同存储引擎具有不同的功能,(索引在该层实现)
4、存储层:主要将数据存储在文件系统之上,并完成与存储引擎的交互
2.2 存储引擎
存储引擎是存储数据、建立索引、更新/查询数据等技术的实现方式
存储引擎是基于表的,不是基于库的,所以存储引擎也可被称为表类型
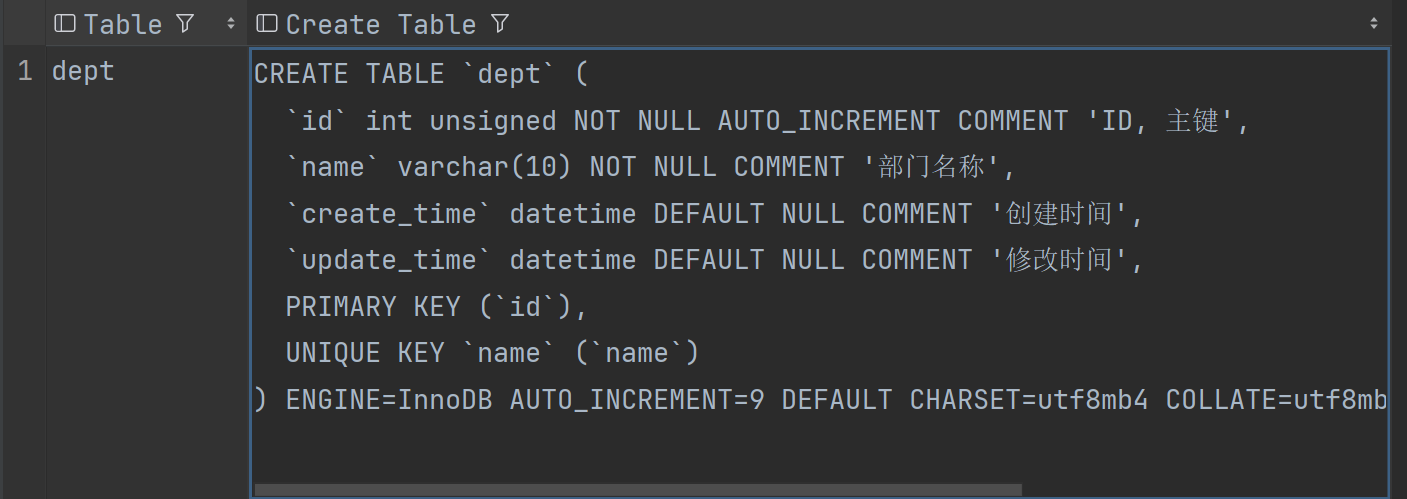
# 查询建表语句
show create table dept;
# 建表时指定存储引擎
engine = InnoDB;
若未指定查询引擎,自动默认InnoDB引擎,如下图
(1)InnoDB 存储引擎
介绍:是一种兼顾高可靠性和高性能的通用存储引擎,是MySQL默认的存储引擎
DML操作遵循ACID模型(事务四特性),支持事务行级锁,提高并发访问性能
支持外键约束,保证数据完整性,正确性
文件.idb :innodb引擎的每张表都会对应一个表空间文件,存储该表的表结构(sdi)、数据、索引
参数:innodb_file_per_table 决定多张表是否对应一个表空间文件,或者一张表对应一个
# 通过sql查询变量,看是否一张表对应一个表空间文件
show variables like 'innodb_file_per_table';
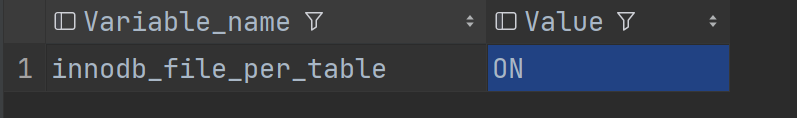
在MySQL文件夹下查看当前数据库中表的ibd文件,一个ibd文件对应一张表,不仅存放表结构、数据,还会存放该表对应的 索引信息,可以通过以下命令查看该表的信息
#由于ibd文件是二进制存储,无法直接查看内容,利用指令查看
ibd2sdi 文件名
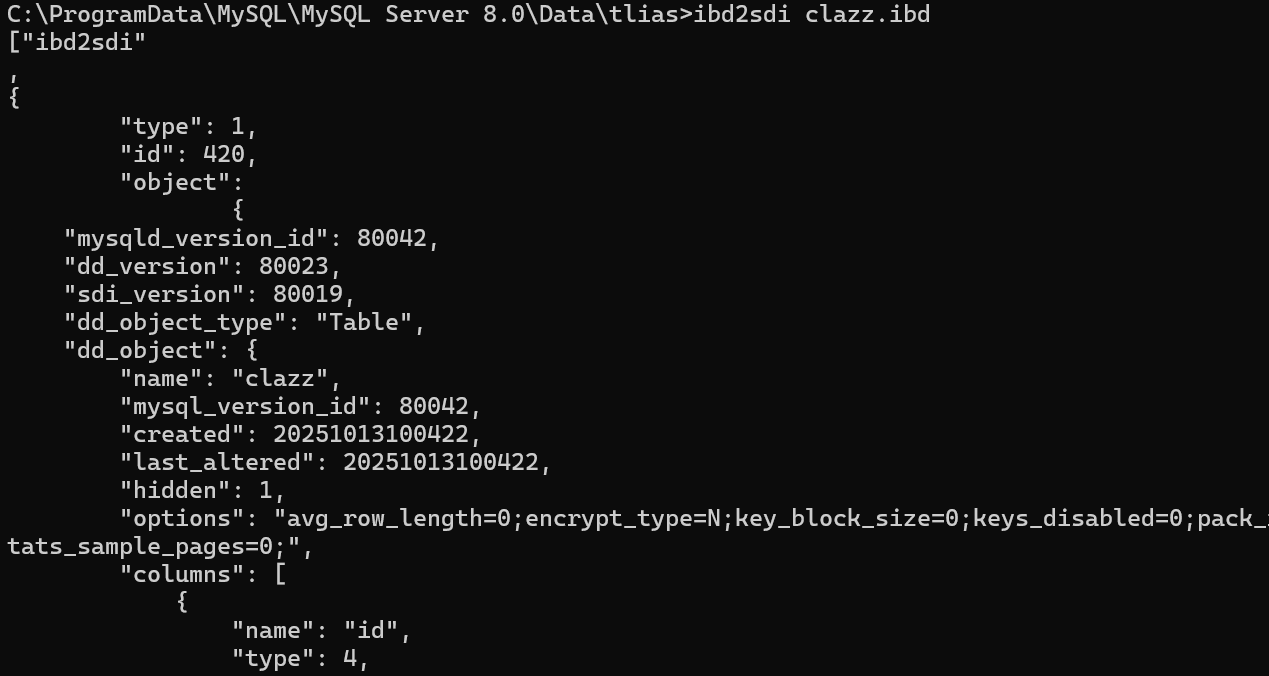
2.2.1 存储引擎的逻辑结构
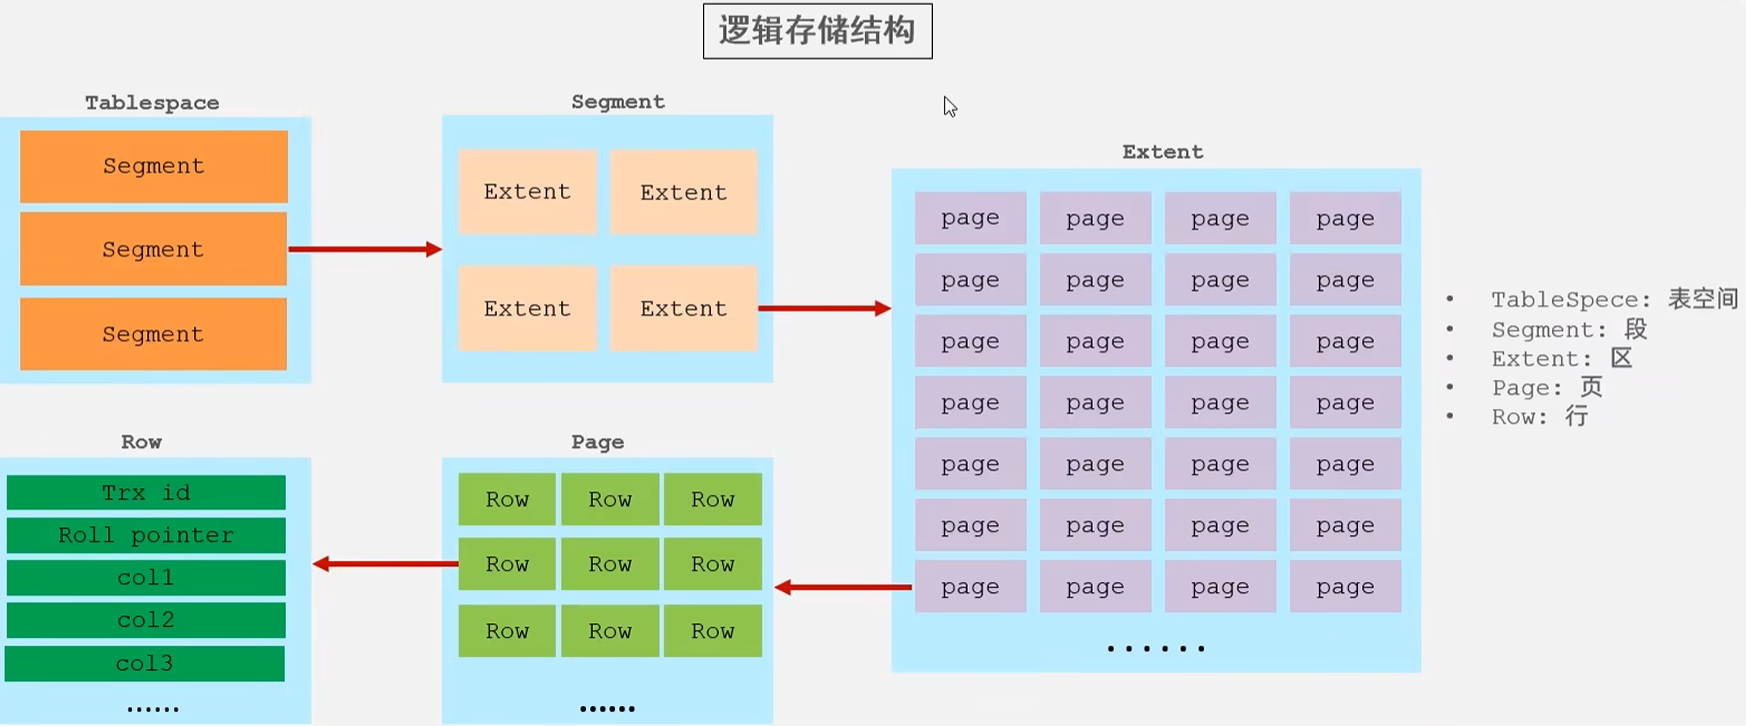
一行中存储的信息:trx_id(最后一次事务操作),roll_pointer(指针),以及字段
磁盘中分为:表空间、段、区、页、行(大小依次递减)
区是空间表结构的单元结构,固定大小为1M(包含64页) InnoDB存储引擎页大小为 16KB, 即一个区中一共有64个连续的页
页 : 页是组成区的最小单元,页也是InnoDB 存储引擎磁盘管理的最小单元,每个页的大小默认为 16KB(16384 B)。为了保证页的连续性,InnoDB 存储引擎每次从磁盘申请 4-5 个区
行 : InnoDB 存储引擎是面向行的,也就是说数据是按行进行存放的,在每一行中除了定义表时 所指定的字段以外,还包含两个隐藏字段(后面会详细介绍)
(2)Memory
Memory引擎的表数据时存储在内存中的,由于受到硬件问题、或断电问题的影响,只能将这些表作为 临时表或缓存使用。
- 内存开放
hash索引(默认)
(3)MyISAM :MySQL早期的默认存储引擎。
- 不支持事务,不支持外键
- 支持表锁,不支持行锁
- 访问速度快
2.2.2 存储引擎的区别
| 特点 | InnoDB | MyISAM | Memory |
|---|---|---|---|
| 存储限制 | 64TB | 有 | 有 |
| 事务安全 | 支持 | - | - |
| 锁机制 | 行锁 | 表锁 | 表锁 |
| B + Tree索引 | 支持 | 支持 | 支持 |
| Hash 索引 | - | - | 支持 |
| 全文索引 | 支持(5.6版本后) | 支持 | - |
| 空间使用 | 高 | 低 | N/A |
| 内存使用 | 高 | 低 | 中等 |
| 批量插入速度 | 低 | 高 | 高 |
| 支持外键 | 支持 | - | - |
2.2.3 存储引擎的选择
- InnoDB:对事务的完整性有较高要求,在并发条件下要求数据一致性,数据需要进行修改操作
- MyISAM:以读、插入操作为主,只有少量的更新删除操作,且对并且对事务的完 整性、并发性要求不是很高
- Memory::将所有数据保存在内存中,访问速度快,通常用于临时表及缓存。MEMORY的缺陷就是 对表的大小有限制,太大的表无法缓存在内存中,而且无法保障数据的安全性。
索引
3.1 索引概述
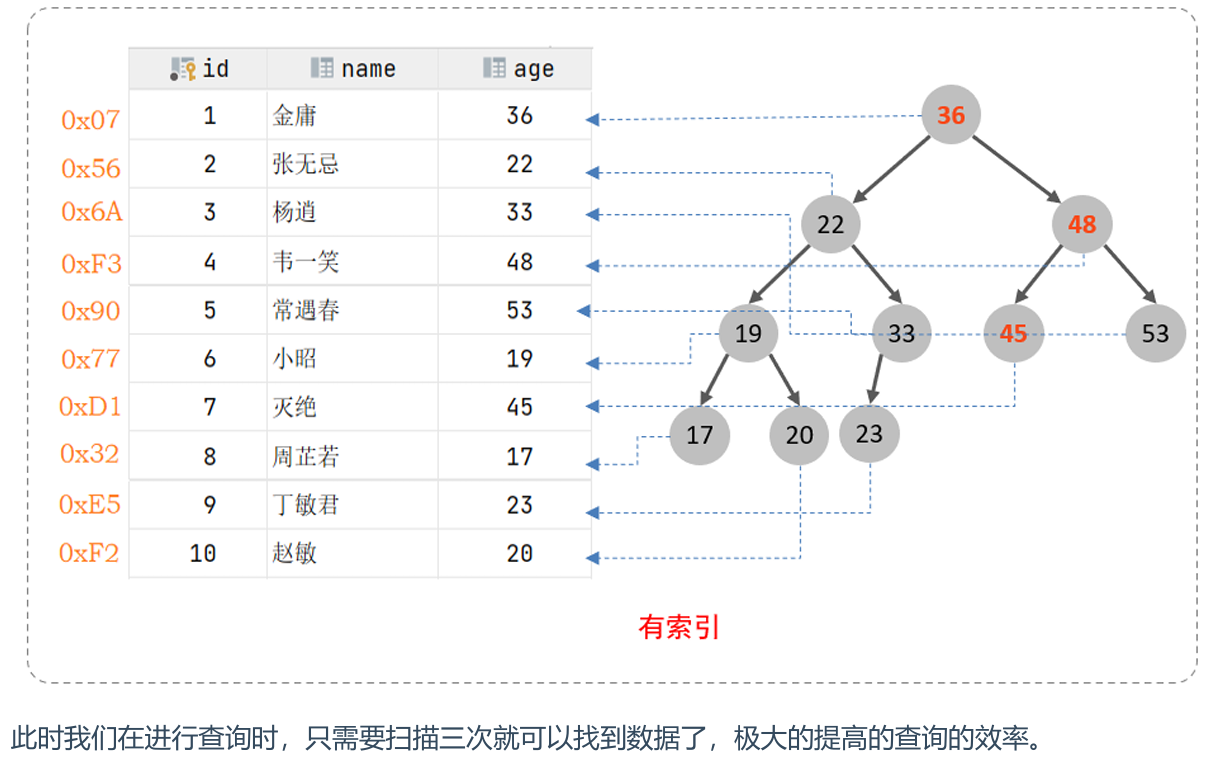
索引(index)是帮助MySQL高效获取数据的数据结构(有序)。在数据之外,数据库系统还维护着满足 特定查找算法的数据结构,这些数据结构以某种方式引用(指向)数据, 这样就可以在这些数据结构 上实现高级查找算法,这种数据结构就是索引。
无索引情况:在无索引情况下,就需要从第一行开始扫描,一直扫描到最后一行,我们称之为全表扫描,性能很低。 有索引情况:如果采用树状结构进行构建索引,那么查找数据的时间复杂度会提升为 $log(n)$ 级别,大大提升了数据的查找效率,如下图
3.2 索引的结构
MySQL的索引是在存储引擎层实现的,不同的存储引擎有不同的索引结构(数据结构),主要包含以下几种:
3.2.1 索引的分类:
- 主键索引:针对于表中主键创建的索引,默认自动创建, 只能有一个(
Primary) - 唯一索引:避免同一个表中某数据列中的值重复,可以有多个(
Unique) - 常规索引:快速定位特定数据,可以有多个
- 全文索引:全文索引查找的是文本中的关键词,而不是比较索引中的值,可以有多个(
Fulltext)
3.2.2 聚集索引&二级索引
| 分类 | 含义 | 特点 |
|---|---|---|
| 聚集索引(Clustered Index) | 每个结点下挂的是主键的值 将索引与数据存储到一起,索引的叶子节点保存了行数据,即该主键值对应的记录,且叶子节点有序 | 必须有,而且只有一个 (主键的索引) |
| 二级索引(Secondary Index) | 将数据与索引分开存储,索引结构的叶子节点关联的是对应的主键 | 可以存在多个 |
聚集索引选取原则:
- 如果存在主键,主键索引就是聚集索引。
- 如果不存在主键,将使用第一个唯一
UNIQUE索引作为聚集索引。 - 如果表没有主键,或没有合适的唯一索引,则
InnoDB会自动生成一个rowid作为隐藏的聚集索引。
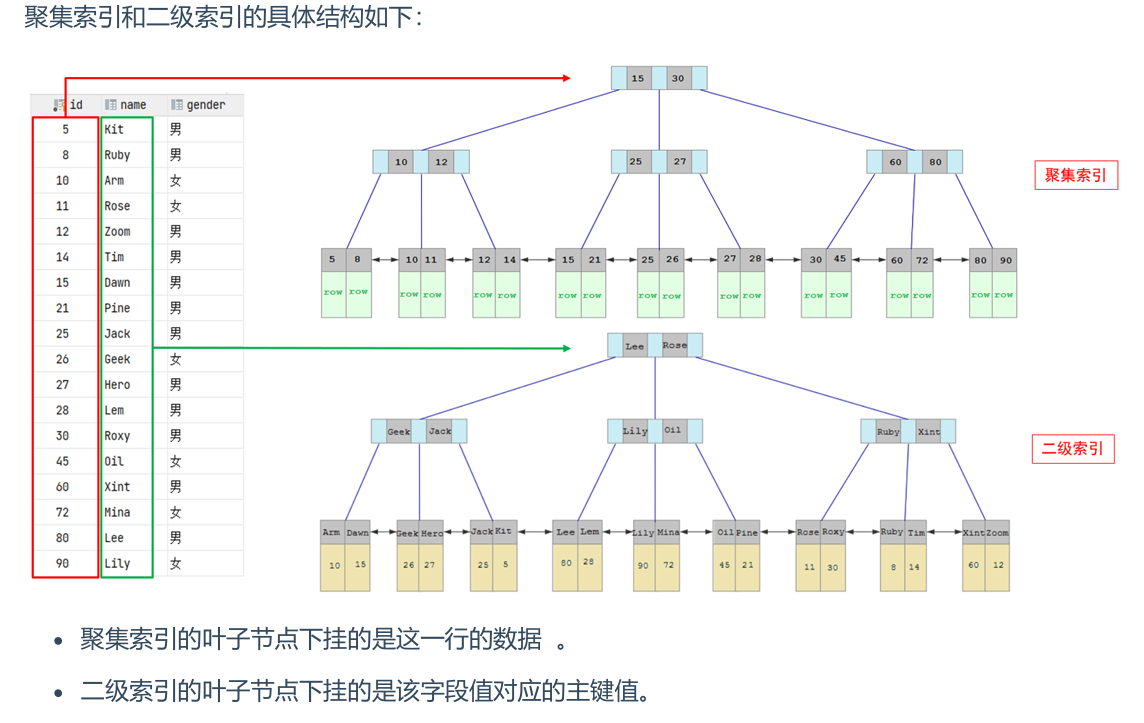
回表查询:先到二级索引中查找数据,找到主键值,然后再到聚集索引中根据主键值,获取 数据的方式,就称之为回表查询。
3.2.3 索引语法
# 1、创建索引
create [unique | primary] index [index_name] on [表名]
# 2、查看索引
show index from [表名]
# 3、删除索引
drop index [index_name] on [表名]
# eg 为user表创建关于 email、age的联合索引
create index in_union on user(email,age)
3.2.4 SQL 性能分析
1、sql执行频率
# 查看当前数据库执行 增删改 的执行次数
--  session 查看当前会话    global   查询全局会话
show [session | global] status

show global status like 'Com%';
通过该命令查询,可以查看当前数据库是以查询为主或以修改为主,从而为数据库优化提供参考依据
如果是以增删改为主,我们可以考虑不对其进行索引的优化。 如果是以 查询为主,那么就要考虑对数据库的索引进行优化了。
2、慢查询日志
该日志记录了所有执行时间超过指定参数(long_query_time单位 s,默认为10秒)的所有SQL语句日志,MySQL默认没有开启,需要写配置文件/etc/my.cnf
慢查询日志在 Linux 下存放位置 /var/lib/mysql/localhost-slow.log
若在查询之后,针对查询耗时长的SQL语句来进行优化
3、查看耗时情况
# profiles 能在SQL优化时帮我们了解 时间在哪里耗时大,have_profiles参数,查看当前MySQL是否支持
# 具体语法
# 1、查看当前数据库是否支持profiles
select @@have_profiling
# 2、默认情况profiling是关闭的(数值为0),需要开启,可以指定会话或者全局级别
set [session | global] profiling = 1
# 3、进行一系列查询,然后查看耗时
select * from tb_user;
select count(*) from tb_user;
show profiles;
show profile for query [id];  # 查看指定id的SQL语句耗时
show profile cpu for query [id]  # 查看指定id的SQL 语句 cpu使用情况
4、explain 执行计划
可以查看表是否使用了索引,表的连接情况,连接顺序等
# 在select 语句之前加上关键字explain / desc
explain select 字段列表 from 表名 where 条件;
下面为explain查询出的各个字段值及其含义:
| 字段 | 含义 |
|---|---|
id | select 查询的序列号,表示查询中执行 select 子句或者是操作表的顺序id相同,执行顺序从上到下;id不同,值越大,越先执行 |
select_type | 表示 SELECT 的类型,常见的取值有 SIMPLE(简单表,即不使用表连接 或者子查询)、PRIMARY(主查询,即外层的查询)、 UNION(UNION 中的第二个或者后面的查询语句)、 SUBQUERY(SELECT/WHERE之后包含了子查询)等 |
type | 表示连接类型,性能由好到差的连接类型为 NULL、system、const、 eq_ref、ref、range、 index、all 。 NULL一般为不访问任何表,system 访问系统表,const 根据唯一索引或主键访问的表,ref 使用非唯一索引访问 |
possible_key | 显示可能应用在这张表上的索引,一个或多个 |
key | 实际使用的索引,如果为NULL,则没有使用索引 |
key_len | 表示索引中使用的字节数, 该值为索引字段最大可能长度,并非实际使用长 度,在不损失精确性的前提下, 长度越短越好 |
rows | MySQL认为必须要执行查询的行数,在innodb引擎的表中,是一个估计值, 可能并不总是准确的 |
filtered | 表示返回结果的行数占需读取行数的百分比, filtered 的值越大越好 |
注:查询时 type字段尽量不要出现all,此为无索引情况下进行全表扫描,性能低
3.3 索引的使用
3.3.1 验证索引的效率
1、索引对于查询效率的提升
(1)准备好大规模的测试数据
mysql在加载大规模数据时会非常耗费CPU及内存 ,已经拆分为5个部分 ,每一个部分为200w数据 ,load 5次即可
使用load data infile语句(SQL优化中insert优化):该语句允许您从本地文件或远程服务器上的文件中将数据加载到MySQL表中。这比使用INSERT语句逐行插入数据更快。示例:
load data load infile [本地路径]
into table [表名]
fields terminated by ','
lines terminated by '\n';
# terminated:结束  filed:字段
(2)在400w 测试数据下
# 根据id(主键)字段进行查询
select * from tb_sku where id = 1;  # 测试耗时 11ms
# 根据 无索引字段 sn 进行查询
select * from tb_sku where name = 'xxx';  # 测试耗时3s 669ms
# 为 sn 字段添加索引,再次查询查看耗时
create index idx_sku_sn on tb_sku(sn);
select * from tb_sku where name = 'xxx';   # 耗时如下图 5ms


3.3.2 索引的使用
以下是几种导致索引可能失效的情况
1、最左前缀法制:如果索引了多列(联合索引),查询从索引最左列开始,并且不跳过索引中的列。若跳过某一列,则索引将部分失效(后面字段的索引失效),这是由于 B+Tree 的特性,部分有序
# 假设现在存在一个联合索引 idx_pro_age_stu
select * from tb_sku where profession = 'xxx' and age = 18 and stus = 'x';  # 使用了索引
select * from tb_sku where age = 18;   # 联合索引失效,因为跳过了最左侧的profession字段
select * from tb_sku where profession = 'xxx' and stus = 'x'  # 仅stus索引部分失效,因为跳过了age字段
2、范围查询:联合索引中,若出现范围查询(<,>),范围查询右侧的列索引失效
select * from tb_sku where profession = 'xxx' and age > 30 and stus = 'x';  # 索引stus失效
# 使用 >= 、<= 、 between 可以避免索引失效
select * from tb_sku where profession = 'xxx' and age >= 30 and stus = 'x';
3、索引列运算
尽量不要在索引列上进行运算,否则索引会失效,引起全表扫描
可能写SQL时会写错类型,如字符串未加引号,导致了隐式类型转换索引失效
# 1、使用函数进行计算导致索引失效
select * from tb_sku where substring(sn,10,2) = '15';
# 2、写错类型导致索引失效
select * from tb_sku where sn = xxx;    # 未加引号索引失效

4、模糊查询 和 or 连接条件
# 1、使用模糊查询
-- 模糊尾部索引不失效,大数据量时避免头部模糊
explain select * from tb_sku where sn like '%11';    # 模糊查询首部模糊会索引失效
select * from tb_sku where sn like '110%';           # 索引不失效,type = range
# 2、or 连接条件
-- or 前后必须都存在索引,否则都不会使用索引
select * from tb_sku where id = 10 or num = 300;
5、数据分布影响
如果MySQL评估使用索引比全表扫描更慢,则不使用索引(大概率在小数据量时出现)
3.3.3 SQL提示
通常数据库会根据查询语句自动判断使用哪个索引,但有些时候使用特定索引会使查询效率更高,因此需要SQL提示
SQL提示是优化数据库的重要手段,就是在SQL语句中加入一些人为提示来达到优化数据库的目的
-- use index  使用索引
explain select * from tb_user use index(idx_user_pro) where profession='xxx';
-- ignore index 忽略索引
explain select * from tb_user ignore index(idx_user_pro) where profession='xxx';
-- force index 必须使用的索引
explain select * from tb_user force index(idx_user_pro) where profession='xxx';
3.3.4 覆盖索引
覆盖索引不是一个特殊的索引类型,而是在一个SQL查询语句中,查询的字段是否需要进行回表查询,简单来说就是能否通过一次的索引扫描查询出所需要的数据。因此在写SQL查询语句中,尽量避免使用select *
下面是一组例子,帮助更好的理解什么是覆盖索引
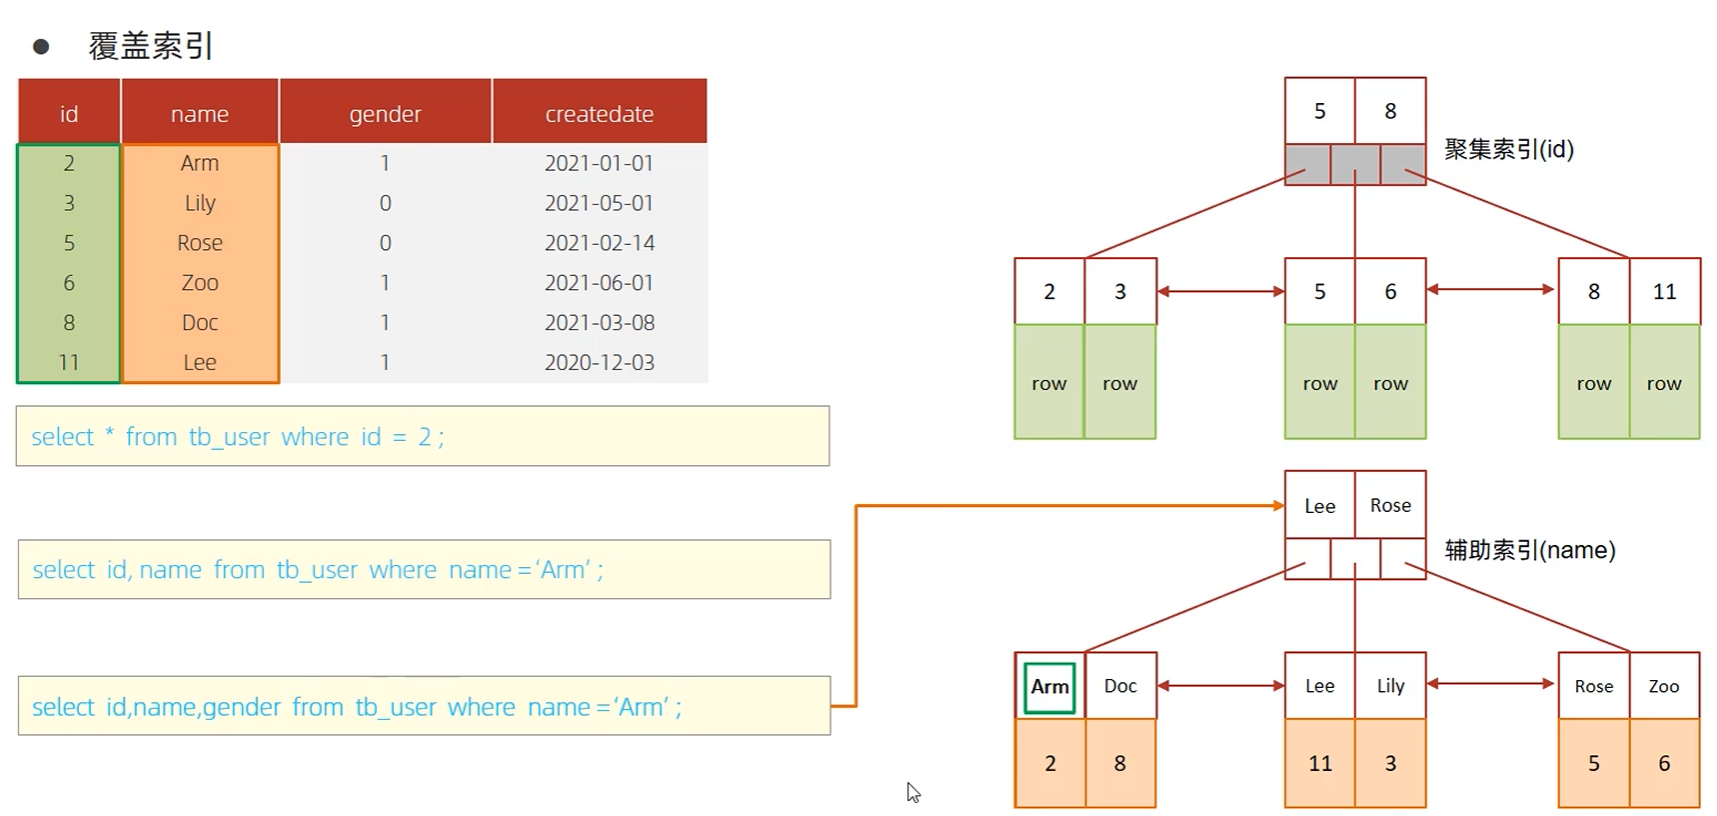
在上图中,第三条SQL查询,因为从二级索引 / 辅助索引 中未能查找到所有需要的列,因此进行了回表查询,效率降低
下面存在一个实际构建索引的问题:
一张表, 有四个字段(id, username, password, status), 由于数据量大, 需要对 以下SQL语句进行优化该如何进行才是最优方案: select id,username,password from tb_user where username = 'itcast';
因为考虑到覆盖索引的问题,需要尽可能避免回表查询,再根据二级索引叶子结点挂载主键值这一特点,所以需要建立一个联合索引,username,password这样查询时只会查询一次二级索引
3.3.5 前缀索引
当查询的字段为varchar、test等时,建立的索引是很长的字符串,会让索引变得很大,空间存储压力很大,浪费磁盘IO,影响查询效率。此时可以将字符串的一部分前缀,建立索引。
# 前缀索引的语法
create index idx_name on 表名(字段名(n))   -- n为截取该字段的前缀长度
前缀长度如何取定?
可以根据索引字段的选择性决定,索引的选择性越高,查询效率越高
索引字段选择性max = 1,性能是最好的
# 选择性:该字段不重复的值占所有记录的比值
count(distinct 字段名) / count(*)      -- 完整字段选择性为1
count(distinct substring(字段,开始,结束)) / count(*)   -- 截取前缀,计算选择性值
通常时候,不一定选取 选择性取最高的前缀,可能会平衡索引的长度和选择性高低
比如在一张数据表中,user(id,name,email) 现在需要对 email 字段建立索引
现在前缀为 10 的索引,选择性为1,前缀为 5 的索引,选择性为 0.95,那平衡索引长度和选择性会将索引建立为前缀5位
3.3.6 索引设计原则
- 针对数据量大,查询比较频繁的表建立索引(数据量 100w+)
- 针对常见查询条件,排序,分组字段建立索引
where、order by、group by - 尽量选择区分度高的列作为索引,尽量建立唯一索引
- 字符串类型字段,长度较长,建立前缀索引(目前所用 倒排索引)
- 尽量使用联合索引,减少单列索引,避免回表查询
- 控制索引数量,维护索引结构需要代价,可能影响增删改效率
- 若索引列不能存储 NULL 值,使用 NOT NULL 约束该字段
SQL优化
4.1 insert 优化
# 插入少量数据
insert into [表名] values(),()……
# 手动控制事务提交
start transaction;
insert into ……
commit;
# 主键顺序插入
乱序: 8 1 9 12 77……
顺序: 1 2 3 4  5……
# 插入大量数据 100w+
-- 1、连接服务端时
mysql --local-infile -uroot -p
-- 2、设置全局参数开关
set global local_infile=1;
-- 3、加载大量数据脚本文件
load data load infile 'xxx'
into table xxx
fields terminated by 'x'
lines terminated by 'x';
4.2 主键优化
首先介绍 数据插入数据库表结构的流程
(1)页分裂
页可以为空,可以填充 一半,可以填充 100%,每个页包含 2~N 行数据,根据主键排列
如果只有一行数据,相当于一个链表,不允许这样存储。一行数据若过大(超过某个阈值)则会行溢出
主键顺序插入:首先申请页,将主键顺序插入,写满第一页后,继续写第二个页,页之间使用双向指针连接
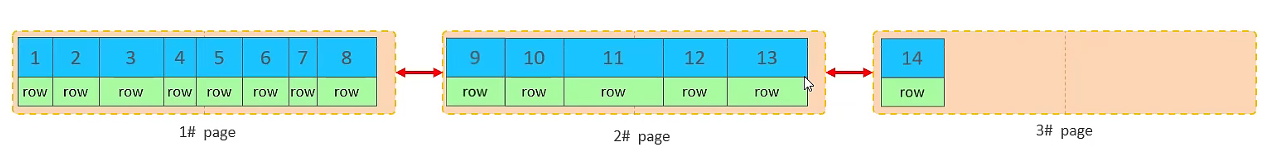
主键乱序插入:申请页,因为需要插入的50应该写入47之后,但第一页写不下,将第一页的一半往后分裂,写入第三页中,50接在第三页的47之后写入,再重新对连接页指针排序
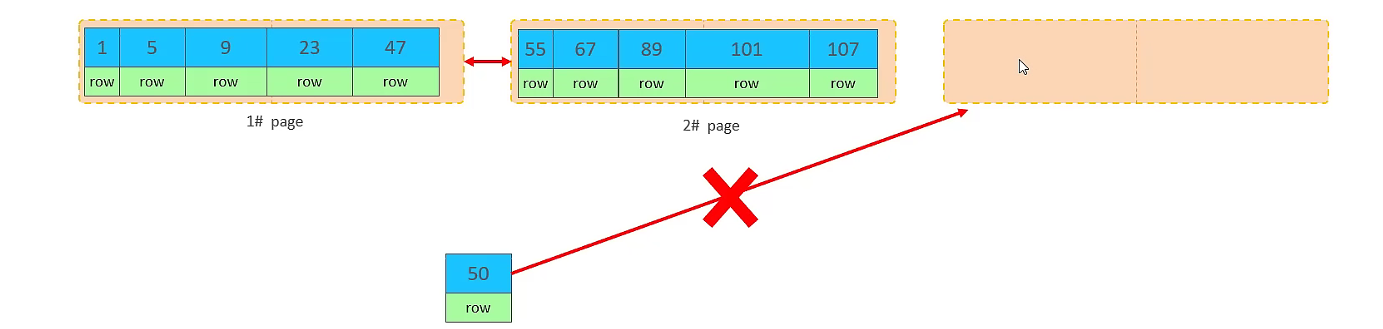
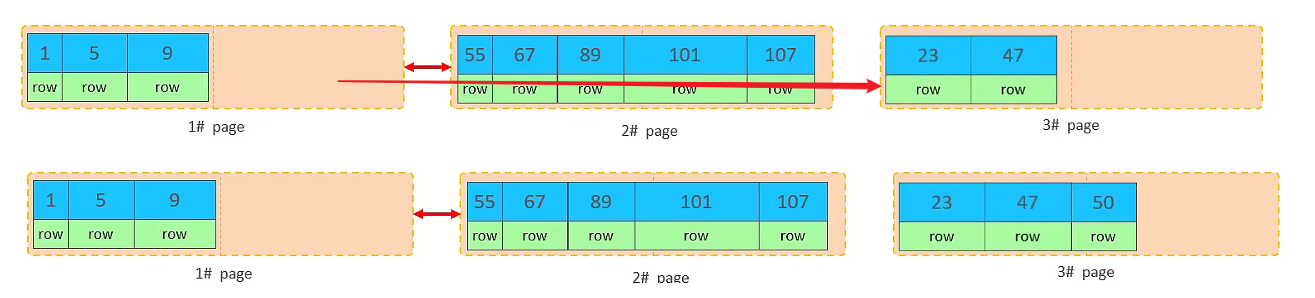
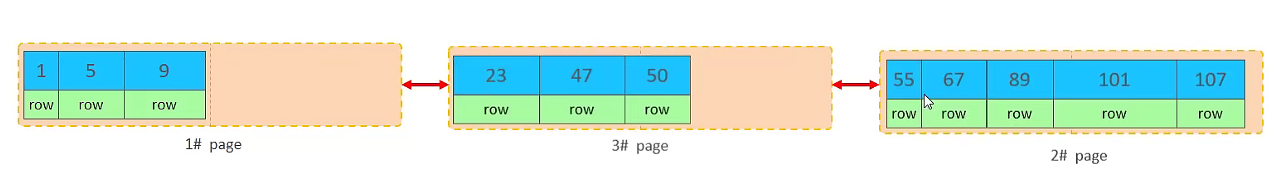
(2)页合并
当删除一行记录时,实际上记录并没有被物理删除,只是记录被标记(flaged)为删除并且它的空间 变得允许被其他记录声明使用。
当页中删除的记录达到 MERGE_THRESHOLD(默认为页的50%),InnoDB会开始寻找最靠近的页(前 或 后)看看是否可以将两个页合并以优化空间使用。
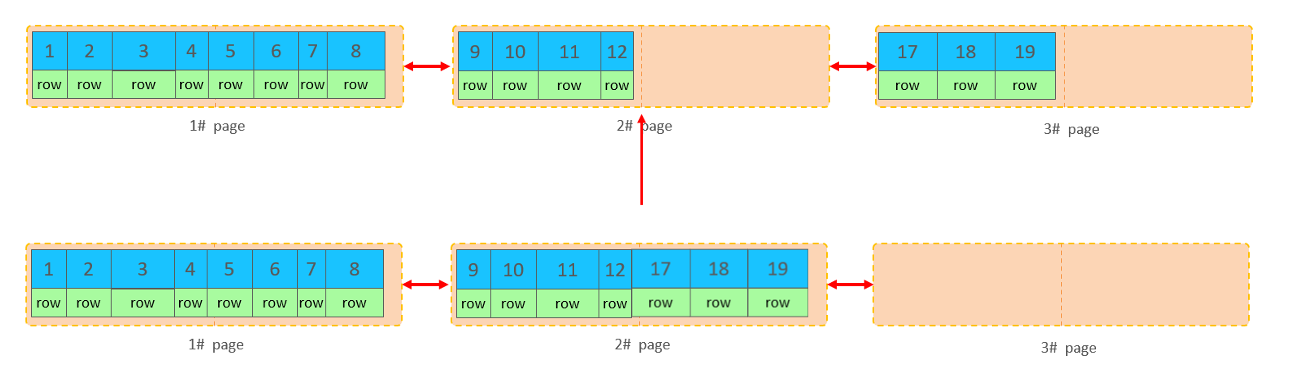
主键设计原则:
- 尽量降低主键长度
- 尽量选择顺序插入,选择
auto_increment自增主键 - 尽量避免使用
UUID做主键,如身份证号 - 业务操作,避免对主键的修改
4.3 order by优化
Using filesort : 通过表的索引或全表扫描,读取满足条件的数据行,然后在排序缓冲区sort buffer中完成排序操作,所有不是通过索引直接返回排序结果的排序都叫 FileSort 排序。
Using index : 通过有序索引顺序扫描直接返回有序数据,这种情况即为 using index,不需要 额外排序,操作效率高。
对于以上的两种排序方式,Using index的性能高,而Using filesort的性能低,我们在优化排序 操作时,尽量要优化为 Using index。
针对多字段排序,order by 采用联合索引需要根据顺序来判断索引是否失效,排序规则使用哪种方式
create index idx_user_age_phone on tb_user(age,phone);
explain select id,age,phone from tb_user order by age,phone;   -- 索引生效,且排序方式 using index
explain select id,age,phone from tb_user order by phone,age;  -- 索引失效,全表扫描
# Backward index scan,这个代表反向扫描索
explain select id,age,phone from tb_user order by age,phone desc;
注:若不可避免出现filesort,大数据量排序,可以适当增大排序缓冲区大小 sort_buffer_size(默认256k)。
4.4 group by 优化
索引对于分组操作的影响
# 在没有索引情况下执行,出现 using temporary 使用了临时表
explain select profession,count(*) from tb_user group by profession;

# 创建联合索引之后,using index
create index isx_user_profession_age on tb_user(profession,age);
explain select profession,count(*) from tb_user group by age;   -- 仍使用临时表,因为不满足最左前缀法则
如果仅仅根据age分组,就会出现 Using temporary ;而如果是 根据 profession,age两个字段同时分组,则不会出现 Using temporary。原因是因为对于分组操作, 在联合索引中,也是符合最左前缀法则的。
4.5 limit 优化
使用场景:数据量较大时,limit 分页起始索引越高,查询越慢,下图是不同索引下的查询时间
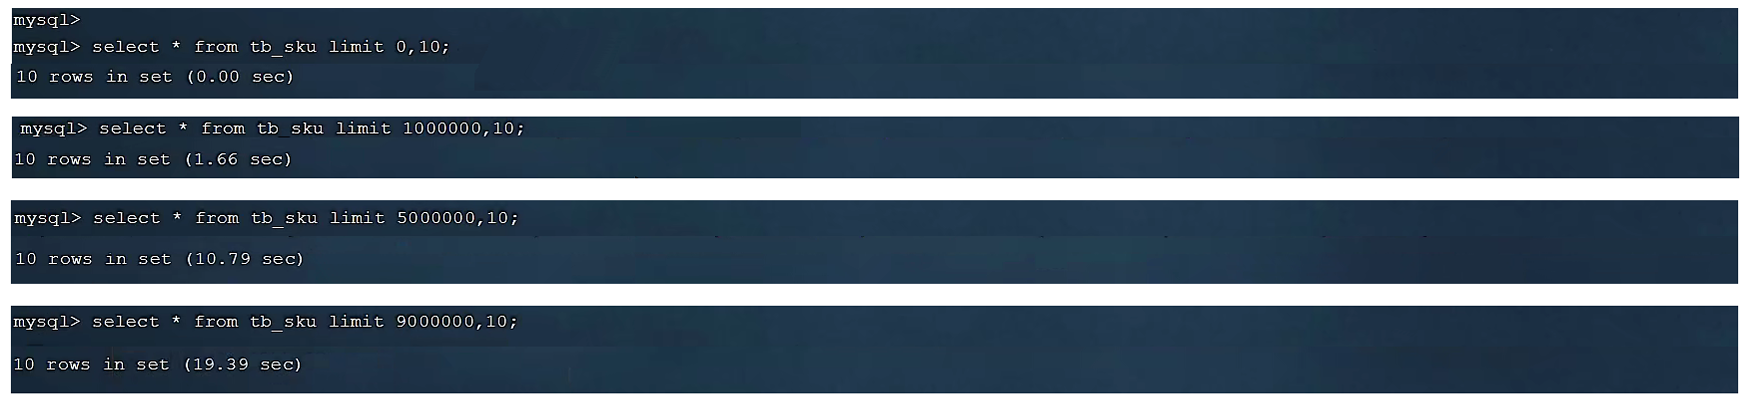
优化思路:创建 覆盖索引 + 子查询 形式优化
# 举个例子,现在需要查询第 200w 索引开始的10条数据,怎样优化

-- 子查询
select id from tb_sku order by id limit(2000000,10);  -- 查询到的所需临时表
-- 完整查询(使用了自连接查询,隐式)
select s.* from tb_sku s, ( select id from tb_user order by id limit 2000000,10 ) a
where s.id = a.id;

select * from tb_sku where id > 3500000 limit 1000;  # 查询速度极快QAQ
4.6 count 优化
在数据量极大时,在 InnoDB 存储引擎中,是很费时的。
- MyISAM 引擎把一个表的总行数存在了磁盘上,因此执行 count(*) 的时候会直接返回这个 数,效率很高; 但是如果是带条件的count,MyISAM也慢。
- InnoDB 引擎就麻烦了,它执行 count(*) 的时候,需要把数据一行一行地从引擎里面读出 来,然后累积计数。
count() 是一个聚合函数,对于返回的结果集,一行行地判断,如果 count 函数的参数不是 NULL,累计值就加 1,否则不加,最后返回累计值。
用法::count(*)、count(主键)、count(字段)、count(数字)
| count用法 | 含义 |
|---|---|
| 主键 | InnoDB 引擎会遍历整张表,把每一行的 主键id 值都取出来,返回给服务层。 服务层拿到主键后,直接按行进行累加 |
| 字段 | 没有not null 约束 : InnoDB 引擎会遍历整张表把每一行的字段值都取出 来,返回给服务层,服务层判断是否为null,不为null,计数累加。有 not null 约束:InnoDB 引擎会遍历整张表把每一行的字段值都取出来,返回给服务层,直接按行进行累加。 |
| 数字 | InnoDB 引擎遍历整张表,但不取值。服务层对于返回的每一行,放一个数字“1” 进去,直接按行进行累加。 |
* | InnoDB引擎并不会把全部字段取出来,而是专门做了优化,不取值,服务层直接 按行进行累加。 |
效率上 count(字段) < count(主键) < count(1) ≈ count(*) , 尽量使用count( *)
4.7 update 优化
update course set name = 'xxx' where id = 1
执行 update 语句更新记录时,会锁定 id = 1这一行的数据,然后事务提交之后,行锁释放。
但是当更新一条记录,若根据无索引字段的条件来更新时,会触发表级锁,导致性能效率降低
-- 当前的 name 字段未建立索引
update course set name = 'xxx' where name = 'xxx'
注:InnoDB的行锁是针对索引加的锁,不是针对记录加的锁 ,并且该索引不能失效,否则会从行锁 升级为表锁 。
存储对象
包含:视图、存储过程、存储函数、触发器
5.1 视图
视图(View)是一种虚拟存在的表。视图中的数据并不在数据库中实际存在,行和列数据来自定义视 图的查询中使用的表,并且是在使用视图时动态生成的。
简单来说,视图只保存了查询的SQL逻辑,不保存查询结果。所以我们在创建视图的时候,主要的工作 就落在创建这条SQL查询语句上。
(1)创建视图
create [or replace] view 视图名称[列名列表] as [select 语句]   with [ cascaded  |  local ]  check  option ]
-- or replace : 替换视图,可省略
-- with cascaded check option : 检查选项,用于通过视图往表中插入修改数据是否满足视图查找条件
(2)查询视图
# 1、查看创建视图语句
show create view 视图名称;
# 2、查看视图数据:可以当作查看表数据
select * from 视图名称 ……;
(3)修改视图
# 两种修改方式
create or replace  view 视图名称[列名列表] as select语句 with [ cascaded  |  local ]  check  option ]
alter view 视图名称[列名列表] as select语句 with [ cascaded  |  local ]  check  option ]
(4)删除
drop view[if exists] 视图名称
视图检查选项
举个例子,在定义视图时,若指定了条件在插入、修改、删除数据时,是否可以做到必须满足 条件才能操作,否则不能够操作呢?
简单说就是比如插入数据时,若不满足创建视图的 select 语句条件,是否可以成功插入数据到表中,这就是检查选项的作用了
当使用with check option子句创建视图时,MySQL会通过视图检查正在更改的每个行,例如 插入,更新,删除,使其符合视图的定义。
MySQL允许基于另一个视图创建视图,它还会检查依赖视 图中的规则以保持一致性。
为了确定检查的范围,mysql提供了两个选项: cascaded和 local ,默认值为 cascaded 。
1 )cascaded:级联,在计算机中指多个对象之间的映射关系,建立数据之间的级联关系提高管理效率
视图 v3 依赖于 v2 视图,v2视图依赖于 v1 视图,由此在创建v3视图时,因为本身没有指定检查选项,只会检查它所依赖的视图即 v1,v2
而创建 v2 时,它本身指定了检查选项,所以本身的条件也会被检查
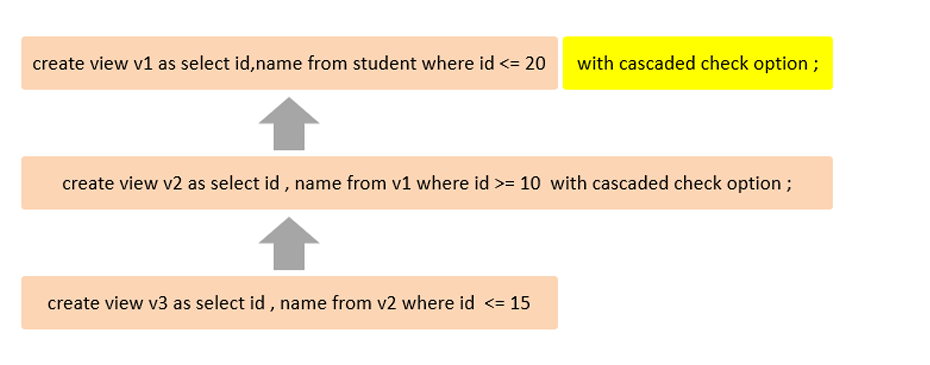
2)local本地
比如,v2 视图是基于 v1视图的,如果在 v2 视图创建的时候指定了检查选项为 local ,但是v1视图创 建时未指定检查选项。 则在执行检查时,知会检查v2,不会检查v2的关联视图v1,简单说就是 local 选项只会关注本身的条件及其来源视图的条件检查。
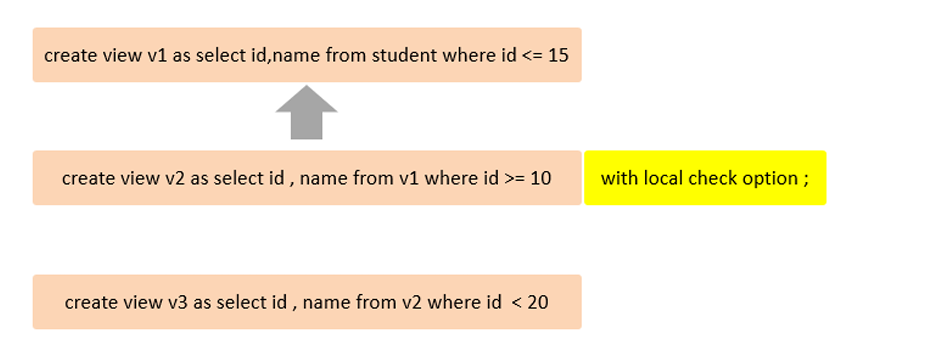
视图的更新
视图中的行与基础表中的行 存在 一对一 关系,如果视图包含以下任何一 项,则该视图不可更新:
聚合函数 或 窗口函数(sum、count 等)、group by 、having、union 或 union all
视图的作用
简单:视图不仅可以简化用户对数据的理解,也可以简化他们的操作。那些被经常使用的查询可以被定义为视 图,从而使得用户不必为以后的操作每次指定全部的条件。
安全:数据库可以授权,但不能授权到数据库特定行和特定的列上。通过视图用户只能查询和修改他们所能见 到的数据
数据独立:视图可帮助用户屏蔽真实表结构变化带来的影响。
比如现在有 学生 和 课程 以及 他们的中间表,现在需要拿到 其中学生的(姓名,学号,所选课程)封装成一个视图,【在后续使用时可以隔离隐私信息,而且起到临时表的作用,简化操作】
# 创建视图使用的 SQL 语句,注意在出现两张表中字段名一致时,需要起别名
select s.name student_name,s.no,c.name course_name from tb_student s,tb_course c,tb_student_course sc
where s.id = sc.student_id and  sc.course_id = c.id;
# 创建视图
create view tb_stu_course_v [上述sql查询语句];
# 查看视图
select * from tb_stu_course_v;
5.2 存储过程
介绍:存储过程是事先经过编译并存储在数据库中的一段 SQL 语句的集合,调用存储过程可以简化应用开发 人员的很多工作,减少数据在数据库和应用服务器之间的传输,对于提高数据处理的效率是有好处的。 存储过程思想上很简单,就是数据库 SQL 语言层面的代码封装与重用。类似于函数和方法。
存储过程的特点:封装 复用、可以接受参数,且可以返回数据、减少网络交互提升效率
5.2.1 基本语法
(1)存储过程的创建
create procedure 名称([参数列表])
begin
	-- SQL 语句
end;
(2)调用
call 存储过程名称([参数]);
(3)查看
select * from information_schema.routines where routine_schema = 'xxx' -- 查询指定的存储过程信息
show create procedure 存储过程名称;    -- 查询某存储过程定义
(4)删除
drop procedure [if exists] 存储过程名称;
注:命令行中执行创建存储过程SQL,需要指定delimiter结束符,如delimiter ;是代表语句以分号为结束标志
5.2.2 变量
MySQL中变量的三种类型:系统变量、用户定义变量、局部变量
(1)系统变量:属于服务器层面,非用户定义的,分为全局和会话global、session
mysql 服务启动后,默认会话变量,若想全局参数不失效,编辑配置文件./my.conf
# 1、查看系统变量
show [session | global] variables [like ‘'xxx'];  -- 可以通过模糊查询
select @@[session | global] 系统变量名;
# 2、设置
set [session | global] 系统变量名 = 值;  -- 也可以使用@@方式
(2)用户定义变量:用户变量不用提前声明,在用的时候直接用 @变量名 使用就可以。其作用域为当前连接。
# 1、赋值(可以使用 = 或者 :=)
set @var_name = 'xxx' , @var_name1 = xxx ……
# 2、使用
select @var_name;
(3)局部变量: 是根据需要定义的在局部生效的变量,访问之前,需要 declare声明。可用作存储过程内的 局部变量和输入参数,局部变量的范围是在其内声明的begin ... end块。
# 声明,变量类型即为数据库字段的类型,default为初始化值
declare 变量名 变量类型 [default ...];
# 赋值
select 字段名 into 变量名 from 表名;
# 示例:
create procedure p1()
begin
	declare stu_count int default 0;
	select count(*) into stu_count from tb_stu;
	select stu_count;
end;
call p1();
5.2.3 if 流程控制
-- elseif 、 else 均为可选
if 条件1 then
	...
elseif 条件2 then
	...
else
	...
end if;
5.2.4 参数
参数分为以下三种:in、out、inout
| 类型 | 含义 | 备注 |
|---|---|---|
in | 该类参数作为输入,也就是需要调用时传入值 | 默认 |
out | 该类参数作为输出,也就是该参数可以作为返回值 | |
inout | 既可以作为输入参数,也可以作为输出参数 |
# 语法
create procedure 存储过程名称([in/out/inout 参数名 参数类型],[]……)
begin
	-- SQL
end;
# 根据传入分数,返回等级
create procedure p1([in score int],[out result varchar(10)])
begin
	if score >= 80 then
		set result = '优秀';
    elseif score >= 60 thens
    	set result = '及格';
    else set result = '不及格';
    end if;
end;
-- 定义用户变量,@result来接受返回数据
set @score = 99,result = '';
call p1(@score,@result);
5.2.5 case
case结构及作用,和我们在基础篇中所讲解的流程控制函数很类似。有两种语法格式:
-- 当case_val 值匹配,执行对应语句
case case_val
	when [val1] then [],
	when [val2] then [],
	……
	else []
end case;
-- 当条件成立时,执行对应语句
case
	when [condition1] then [],
	when [condition2] then [],
	……
	else []
end case;
5.2.6 循环
while 循环是有条件的循环控制语句。
while 条件 do
	-- SQL语句
end while;
repeat 是带有条件的循环控制语句,当满足until声明的条件的时候,则退出循环 。
--  先执行一次逻辑,然后判定UNTIL条件是否满足,如果满足,则退出。如果不满足,则继续下一次循环
repeat
	-- SQL语句
	until 条件
end repeat;
loop 循环,如果不在SQL逻辑中增加退出循环的条件,可以用其来实现简单的死循环。
# begin_label、end_label 是自定义的两个标记
[begin_label:] loop
	-- SQL
end loop [end_label];
leave label;     -- 退出指定标记的循环体
iterate label;  -- 直接进入下一次循环
# 例:计算1+……+n 值,n为传入参数
create procedure p1(in n int)
begin
	declare tol int default 0;
	sum:loop      -- 循环开始标志
		if n<= 0 then
			leave sum;
         end if;
         set tol = tol + n;
         set n = n - 1;
     end loop sum;   -- 循环结束标志
     select tol;
 end;
5.2.7 游标
游标(CURSOR)是用来存储查询结果集的数据类型 , 在存储过程和函数中可以使用游标对结果集进 行循环的处理。游标的使用包括游标的声明、OPEN、FETCH 和 CLOSE,其语法分别如下。
可以类比于 程序语言中的指针
# 声明游标
declare 游标名称 cursor for 查询语句;
# 打开游标
open 游标名称;
# 获取游标记录,一个变量可以接收一个字段的一个值
fetch 游标名称 into [变量1,变量2……];
# 关闭游标
close 游标名称;
若希望在调用存储过程中,使用循环 配合 游标进行数据的读取以及修改等操作,由于没有退出条件导致游标无法结束,需要借助 MySQL中提供的 条件处理程序 Handler 来解决。(类似于 编程语言中的捕捉异常并处理)
DECLARE  handler_action handler for [condition_val……] [statement];

-- handler_action 的取值:
	CONTINUE: 继续执行当前程序
	EXIT: 终止执行当前程序
-- condition_value 的取值:
	SQLSTATE  sqlstate_value: 状态码,如 02000
	SQLWARNING: 所有以01开头的SQLSTATE代码的简写
	NOT FOUND: 所有以02开头的SQLSTATE代码的简写
	SQLEXCEPTION: 所有没有被SQLWARNING 或 NOT FOUND捕获的SQLSTATE代码的简写
5.2.8 存储函数
存储函数是具有返回值的存储过程,且存储函数的参数类型只能是in类型的
create function 存储函数名称(参数列表)
returns type [characteristic]
begin
	-- SQL语句
	return ……;
end;
-- characteristic说明
-- deterministic:相同的输入参数产生相同的结果
-- no SQL:不包含SQL语句
-- reads SQL data:包含读取数据的语句,但不包含写入数据的语句
5.3 触发器
触发器是与表有关的数据库对象,,指在insert/update/delete之前(before)或之后(after),触发并执行触发器中定义的SQL语句集合。触发器的这种特性可以协助应用在数据库端确保数据的完整性 ,日志记录,数据校验等操作。
使用别名old和new来引用触发器中发生变化的记录内容,这与其他的数据库是相似的。现在触发器还只支持行级触发,不支持语句级触发。
行级触发:执行一条 update 语句,影响了5行,触发器被触发了5次
语句级触发:不管影响了多少行,执行几条SQL被触发几次
| 触发器类型 | new 和 old |
|---|---|
| insert 型触发器 | new 表示将要或者已经新增的数据 |
| update 型触发器 | old 表示修改之前的数据 ,new 表示将要或已经修改后的数据 |
| delete 型触发器 | old 表示将要或者已经删除的数据 |
# 触发器创建
create trigger 触发器名称
[before | after] [insert|update|delete]
on 表名 for each row    -- 行级触发器
begin
	-- 执行的SQL语句
end;
# 查看触发器
show triggers;
# 删除触发器
drop trigger [schema_name.]触发器名称;  -- 不加数据库名称,默认删除当前数据库的触发器
-- 示例:通过触发器记录 tb_user 表的数据变更日志,将变更日志插入到日志表user_logs中,insert
-- 准备工作 : 日志表 user_logs
create table user_logs(
	id int(11) not null auto_increment,
	operation varchar(20) not null comment '操作类型, insert/update/delete',
	operate_time datetime not null comment '操作时间',
	operate_id int(11) not null comment '操作的ID',
	operate_params varchar(500) comment '操作参数',
	primary key(`id`)
)engine=innodb default charset=utf8;
-- 变更日志,insert触发,update,delete大致相同
create trigger tb_user_add_trigger after insert on tb_user for each row
begin
	insert into user_logs values(
    	null,'insert',now(),new.id,
        concat('新插入的数据为:id=',new.id,',name=',new.name,',phone=',new.phone,',email=',new.email
              ',profession=',new.profession)
    );
end;
锁
锁是计算机协调多个进程或线程并发访问某一资源的机制。在数据库中,除传统的计算资源(CPU、 RAM、I/O)的争用以外,数据也是一种供许多用户共享的资源。如何保证数据并发访问的一致性、有效性是所有数据库必须解决的一个问题,锁冲突也是影响数据库并发访问性能的一个重要因素。从这个 角度来说,锁对数据库而言显得尤其重要,也更加复杂。
在MySQL中,锁的类型分为
- 全局锁:锁定数据库中的所有表
- 表级锁:每次操作锁住整张表
- 行级锁:每次操作锁住对应的行数据
6.1 全局锁
全局锁就是对整个数据库实例加锁,加锁后整个实例就处于只读状态,后续的DML的写语句,DDL语句,已经更新操作的事务提交语句都将被阻塞。
全局锁的应用场景:全库备份,锁定所有表,保证数据一致性。
如下图,若在备份数据时没有全库锁定,备份第一张表时,业务关联到库存,订单,日志,仅仅备份了在新业务来之前的库存数据,后续业务仍然写入,订单,日志增加了,但是库存却没有减少,造成了数据不一致,因此需要对全库锁定
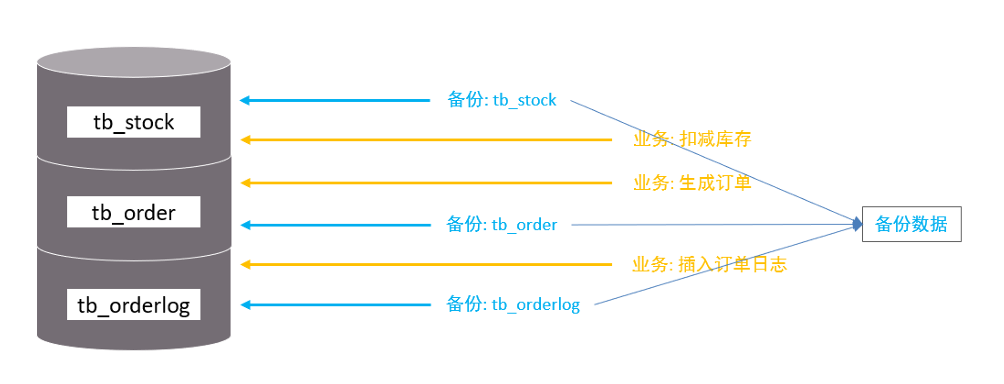
mysql 中的工具 mysqldump,可以备份数据库数据,锁定后数据只能读取,不能修改
# 1、锁定数据库
flush tables with read lock;
# 2、备份数据(注意该工具不是sql语句,在命令行下执行即可)
mysqldump -u root -p xxx [数据库名] > [备份的数据库文件.sql]
# 3、解锁
unlock tables;
数据库中加全局锁,是一个比较重的操作,存在以下问题:
- 如果在主库上备份,那么在备份期间都不能执行更新,业务基本上就得停摆。
- 如果在从库上备份,那么在备份期间从库不能执行主库同步过来的二进制日志(binlog),会导 致主从延迟。
6.2 表级锁
每次操作锁住整张表,锁的粒度(作用范围)大,发生锁冲突的概率最高,并发度最低。
存在三类表级锁:表锁、元数据锁(meta data lock,MDL)、意向锁
(1)表锁:共享读锁(read lock)、独占写锁(write lock)
# 加锁
lock tables 表名…… read/write
# 释放锁
unlock tables;   -- 或者客户端断开连接
对于读锁,会阻塞其他客户端的写入功能,对于写锁,会阻塞其他客户端的读和写功能(当前操作客户端不受影响)
(2)元数据锁
针对元数据加的一把锁,MDL
元数据:表名、字段名、字段类型,可以理解为表结构
元数据锁有4种类型锁:MDL_SHARED、MDL_SHARED_READ、MDL_SHARED_WRITE、MDL_EXCLUSIVE,这四种值分别对应
需要读取元数据,修改元数据,读取表数据,修改表数据
# 比如现在执行,这里只需要读取元数据,所以加的是 MDL_SHARED
create table t2 like t1;
-- MDL_SHARED_READ,需要读取元数据,表数据
select ……
-- MDL_SHARED_WRITE,需要读取元数据,修改表数据
insert | update | delete
-- MDL_EXCLUSIVE,需要修改元数据,修改表数据
DDL 语句
连接属于 MySQL层概念,事务属于 InnoDB 的概念,在 sql 执行时,优先执行MySQL层语句
一个连接给某张表加上了元数据锁,其他连接是否能操作这张表?这牵扯到 锁兼容 的概念
锁兼容:连接1 加上 A 锁,连接2想加 B锁,如果A和B锁兼容,则连接2加上B锁,否则需要等待连接1释放A锁
MDL_SHARED | MDL_SHARED_READ | MDL_SHARED_WRITE | MDL_EXCLUSIVE |
|---|---|---|---|
MDL_SHARED | + | + | + |
MDL_SHARED_READ | + | + | + |
MDL_SHARED_WRITE | + | + | + |
MDL_EXCLUSIVE | - | - | - |
上表中,以横向为第一连接,纵向为第二连接,若修改了元数据,必定会影响其他操作,所以MDL_EXCLUSIVE和谁都不兼容
MDL 对所有 DML 语句 加 读锁,所有 DDL 语句 加 写锁(这里的锁都是表级的),读写锁阻塞关系(默认开启了事务):
- 读锁和写锁会阻塞,即同一个表的 DML 和 DDL 相互阻塞
- 写锁和写锁会阻塞,即两个
Session不能同时对表定义更改,只能串行操作 - 读锁和读锁不会阻塞,即 增删改查不会因为
MDL产生阻塞,可以并发执行
# 查看元数据锁
select object_type,object_schema,object_name,lock_type,lock_duration from
	performance_schema.metadata_locks;
(3)意向锁
为了避免 DML 执行时,加的行锁和表锁的冲突,在 InnoDB 中引入意向锁,使得表锁不需要每行检查数据是否加锁,使用意向锁来减少表锁的检查。
意向共享锁(IS):与 表锁 read 兼容,与 write 互斥
意向排他锁(IX):与 read、write 都互斥
-- 添加 IS
select …… lock in share mode;
-- 添加 IX
insert | update | delete | select …… for update;
6.3 行级锁
行级锁,每次操作锁住对应的行数据。锁定粒度最小,发生锁冲突的概率最低,并发度最高。应用在 InnoDB存储引擎中。
InnoDB的数据是基于索引组织的,行锁是通过对索引上的索引项加锁来实现的,而不是对记录加的锁。对于行级锁,主要分为以下三类:
- 行锁
Record Lock::锁定单个行记录的锁,防止其他事务对此行进行update和delete。在 RC、RR隔离级别下都支持 - 间隙锁
Gap Lock:锁定索引记录间隙(不含该记录),确保索引记录间隙不变,防止其他事务在这个间隙进行insert,产生幻读。在RR隔离级别下都支持 - 临键锁
Next-Key Lock:行锁和间隙锁组合,同时锁住数据,并锁住数据前面的间隙Gap。 在RR隔离级别下支持
在 InnoDB 中实现了两种行锁
共享锁(S):允许一个事务去读一行,阻止其他事务获得相同数据集的排它锁。
排他锁(X):允许获取排他锁的事务更新数据,阻止其他事务获得相同数据集的共享锁和排他锁。
| SQL | 行锁类型 | 说明 |
|---|---|---|
| insert | 排他锁 | 自动加锁 |
| update | 排他锁 | 自动加锁 |
| delete | 排他锁 | 自动加锁 |
| select | 不加任何锁 | - |
注:InnoDB 中的行锁是对于索引加的锁,而不走索引(或索引失效)检索数据,则会对全表加锁,即升级为表锁
# 以学生表(id,name,no)表为例,表中id为主键索引且无其他索引字段,执行update 加行锁的操作
-- 会话1
begin;
update tb_user set name = 'xxx' where name = 'yyy';
-- 会话2
begin;
update tb_user set name='23' where name = 'sdf';   -- 此时会话2中的update语句被阻塞,因为会话1对tb_user加了表锁
间隙锁
通常在加行级锁时,用到间隙锁最多,因为当在索引上扫描数据时,为防止其他事务插入间隙(造成幻读、不可重复读、脏读问题)
所以隔离级别 为 RR 都支持
且间隙锁是可以共存的,即多个事务可以在同一个间隙上加锁
MySQL 常用工具
这里所介绍的工具不是 mysql 服务,是指 mysql 的客户端工具
1、mysql
mysql [option] [database]
--
  -u : username
  -p : password
  -h : hostname (域名或 IP地址)
  -P : port (端口号)
  -e : execute  (执行SQL语句并退出)
2、mysqladmi
是一个执行管理操作的客户端程序,可以检查服务器配置和当前状态,创建并删除数据库等
mysqladmin [option] command
--
   -u : username
   -p : password
   -e : execute (执行SQL语句并退出)
3、mysqlbinlog
服务器生成的二进制日志文件 以 二进制格式保存,使用该工具查看日志或保存
mysqlbinlog log-file1 log-file2 ……
--
   -d : database
   -o : offset (忽略掉日志中的前n行命令)
   -r : result (将输出的文本格式日志输出到指定文件)
   -s : short  (显示简单格式,忽略一些信息)
4、mysqlshow
客户端对象查找工具,快速查找数据库、数据库表、表中索引等信息
mysqlshow -uroot -pxxx
--
   -count   (显示数据库及表的统计信息,可以不指定数据库、表)
5、mysqldump
客户端用来备份数据库数据工具
mysqldump [option] database(待备份数据库) > 备份路径及备份文件名
连接选项:
	-u : username
	-p : password
	-h
	-P
输出选项:
	-T : --tab=name (自动生成两个文件,一个.sql(表结构语句),另一个.txt(数据文件))
6、mysqlimport
客户端导入数据工具
mysqlimport [option] db_name testfile testfile2 ……